GPT-6 vs GPT-5.6: sei modelli a confronto per uso e costo API
La differenza principale tra GPT-6 Astra, Sol e Luna e GPT-5.6 Sol, Terra e Luna riguarda l'equilibrio tra capacità, efficienza e costo API (interfaccia di programmazione delle applicazioni, che consente al software di comunicare con un servizio). Parti da GPT-6 Astra per i compiti aperti più difficili, valuta GPT-6 Sol quando servono capacità e costi bilanciati e prova GPT-6 Luna per attività ben delimitate ad alto volume.
Nella famiglia GPT-5.6, Sol è il modello di punta, Terra bilancia intelligenza e costo e Luna si rivolge ai carichi sensibili alla spesa. Il nome Sol condiviso non significa che GPT-6 Sol e GPT-5.6 Sol occupino la stessa posizione nelle rispettive famiglie.
Ambito: modelli API OpenAI, non abbonamenti
Il confronto riguarda gpt-6-astra, gpt-6-sol, gpt-6-luna e i tre modelli GPT-5.6. Questi prezzi dei token sono separati dagli abbonamenti ChatGPT e Codex; anche accesso ai modelli, opzioni di ragionamento e limiti d'uso variano nei prodotti.
GPT-6.1 Sol è già disponibile a ottobre 2026: GPT-6 Sol non va quindi interpretato come il Sol più recente. L'articolo mantiene il confronto tra sei modelli per chi li valuta o gestisce un sistema esistente. Per il successore, consulta l'articolo su GPT-6.1 Sol e la guida ufficiale aggiornata.
I ruoli documentati sono punti di partenza, non una classifica misurata per ogni attività. La guida ufficiale alla scelta suggerisce confronti sugli stessi input tra modelli e livelli di ragionamento. Le nuove raccomandazioni di quella pagina non vanno attribuite automaticamente al precedente GPT-6 Sol.
I sei modelli a colpo d'occhio
| Modello | Posizione nella famiglia | Impieghi iniziali da valutare | Prezzo input | Prezzo output |
|---|---|---|---|---|
| GPT-6 Astra | Capacità più elevata | Ragionamento complesso, ricerca, codice, uso del computer e risultati impegnativi | $10.00 | $50.00 |
| GPT-6 Sol | Equilibrio tra capacità e costo | Codice, ricerca, scrittura e flussi quotidiani con strumenti | $2.00 | $10.00 |
| GPT-6 Luna | GPT-6 più efficiente | Classificazione, estrazione, trasformazioni semplici e automazioni ad alto volume | $0.10 | $0.50 |
| GPT-5.6 Sol | Modello di punta GPT-5.6 | Lavoro professionale complesso, codice, interfacce e strumenti | $4.00 | $20.00 |
| GPT-5.6 Terra | Equilibrio tra intelligenza e costo | Analisi di media complessità, elaborazione documenti e automazione | $2.00 | $12.00 |
| GPT-5.6 Luna | GPT-5.6 orientato al risparmio | Estrazioni semplici, classificazioni, riassunti e flussi ripetibili | $0.20 | $1.20 |
I valori provengono dalle sei pagine ufficiali dei modelli e sono in dollari statunitensi per un milione di token di testo, con elaborazione Standard e prompt brevi, esclusi i costi degli strumenti. Input in cache, contesti lunghi, Batch, Flex e Fast possono avere tariffe diverse. Controlla la pagina aggiornata dei prezzi API OpenAI prima di distribuire un'applicazione.
Come si collegano Astra, Sol, Terra e Luna?
GPT-6 comprende Astra, Sol e Luna: Astra punta ai compiti più impegnativi, Sol bilancia capacità e costo e Luna privilegia l'efficienza. GPT-5.6 usa Sol, Terra e Luna per le fasce di punta, bilanciata ed efficiente. OpenAI descrive GPT-5.6 Terra come grosso modo corrispondente alla precedente fascia mini e GPT-5.6 Luna alla precedente fascia nano. L'alias API gpt-5.6 indirizza a GPT-5.6 Sol.
| Ruolo nella famiglia | GPT-6 | GPT-5.6 |
|---|---|---|
| Capacità più elevata | Astra | Sol |
| Fascia bilanciata | Sol | Terra |
| Fascia efficiente | Luna | Luna |
La tabella descrive i ruoli interni alle famiglie. Non afferma che modelli sulla stessa riga abbiano qualità, velocità o funzioni equivalenti tra generazioni. In particolare, GPT-6 Sol è l'opzione bilanciata di GPT-6, mentre GPT-5.6 Sol è il modello di punta di GPT-5.6.
GPT-6 Astra: per il lavoro completo più difficile
L'ID è gpt-6-astra. OpenAI presenta Astra come il proprio modello più capace per ragionamento complesso, ingegneria del software, uso del computer, ricerca e creazione di documenti. È il candidato iniziale più forte quando servono più passaggi tra file, strumenti e requisiti incerti.
- Progetti con requisiti incompleti che richiedono giudizio attento
- Flussi di sviluppo lunghi, dalla progettazione all'implementazione e alla verifica
- Ricerche che devono conciliare fonti contrastanti e spiegare l'incertezza
- Attività complesse tra documenti, dati, browser e software professionale
Astra ha i prezzi dei token più alti del confronto. La guida ai modelli GPT-6 riferisce però che in alcune valutazioni ha prodotto risultati migliori con meno token di output rispetto a modelli precedenti. Non è una stima del costo del tuo lavoro: confronta la spesa totale per risultato accettato, includendo tentativi ripetuti e revisione.
GPT-6 Sol: capacità e costo bilanciati
L'ID è gpt-6-sol. È progettato per codice complesso e flussi agentici, nei quali il modello usa strumenti per portare avanti una sequenza di azioni, a un prezzo per token inferiore ad Astra. Vale la pena provarlo quando l'obiettivo è chiaro ma servono giudizio, strumenti e un risultato rifinito.
- Sviluppo ordinario di funzionalità, debug, revisione del codice e test
- Scrittura che richiede ricerca e controllo delle fonti
- Flussi tra fogli di calcolo, documenti, browser e file
- Compiti articolati la cui ambiguità non richiede il modello di capacità massima
Tra questi sei modelli, Sol può essere una base pratica quando il costo conta. Confronta Astra se trascura requisiti importanti e Luna se un compito più delimitato potrebbe riuscire a minor prezzo. È una strategia di valutazione per questo confronto, non l'affermazione che GPT-6 Sol sia oggi il modello predefinito di ogni prodotto. La documentazione ufficiale sul codice tratta anche GPT-6.1 Sol come modello generale più recente.
GPT-6 Luna: compiti delimitati ed efficienti su larga scala
L'ID è gpt-6-luna. OpenAI lo descrive come il GPT-6 più efficiente per attività focalizzate ad alto volume. Ha i prezzi di input e output più bassi tra i sei modelli dell'articolo.
- Estrarre e classificare informazioni in un formato definito
- Produrre riassunti brevi, cambi di stile e metadati
- Modificare file entro limiti precisi e ripulire dati
- Preparare molte bozze da sottoporre a revisione umana
Per attività ambigue o ad alto impatto, nuovi tentativi e correzioni umane possono annullare il vantaggio del prezzo basso. Fornisci istruzioni circoscritte, specifica il formato e verifica un campione dei risultati rispetto a uno standard chiaro.
GPT-5.6 Sol: il modello di punta GPT-5.6
L'ID è gpt-5.6-sol e l'alias gpt-5.6 gli indirizza le richieste. La pagina ufficiale lo identifica come modello di punta GPT-5.6 per lavoro professionale complesso.
Per un'applicazione nuova, confronta i modelli GPT-6 prima di scegliere GPT-5.6 Sol. Un'applicazione esistente può però avere prompt, valutazioni e obiettivi operativi calibrati su GPT-5.6 Sol. Confronta gli stessi compiti per qualità, latenza, uso dei token e frequenza degli errori prima di modificare un flusso in produzione.
La compatibilità va valutata e non giustifica il mantenimento indefinito di un modello precedente. Prova prompt, schemi di output e flussi degli strumenti esistenti per rilevare regressioni. Se un modello più recente o economico soddisfa gli stessi criteri, può ridurre i costi; conserva la configurazione precedente mentre verifichi il passaggio.
GPT-5.6 Terra: fascia intermedia per carichi 5.6
L'ID è gpt-5.6-terra. La pagina ufficiale Terra lo colloca tra intelligenza e costo, grossomodo nella precedente fascia GPT-5 mini.
Terra può adattarsi a elaborazione documenti, generazione di contenuti, analisi e automazione che richiedono più giudizio di una semplice estrazione. Alle tariffe Standard indicate, l'input costa però quanto GPT-6 Sol e l'output di più. Verifica compatibilità, qualità delle risposte e latenza prima di sceglierlo solo per il prezzo.
GPT-5.6 Luna: flussi 5.6 attenti ai costi
L'ID è gpt-5.6-luna. La pagina ufficiale Luna descrive un modello per grandi volumi sensibili alla spesa, grossomodo nella precedente fascia nano.
È un candidato per classificazione, estrazione e brevi riassunti con criteri di output chiari. Alle tariffe Standard per prompt brevi della tabella, GPT-6 Luna costa meno di GPT-5.6 Luna sia in input sia in output. Per attività nuove valuta prima GPT-6 Luna, mantenendo GPT-5.6 Luna nel confronto quando conta la compatibilità con un sistema 5.6 esistente.
Specifiche comuni e differenze significative
| Specifica | Famiglia GPT-6 | Famiglia GPT-5.6 |
|---|---|---|
| Finestra di contesto | 1,050,000 token | 1,050,000 token |
| Spazio aritmetico residuo riservando l'output massimo | 922,000 token | 922,000 token |
| Output massimo | 128,000 token | 128,000 token |
| Modalità immagini | Input immagini; output testo | Input immagini; output testo |
| Intensità di ragionamento | Astra: da low a max Sol e Luna: da none a max |
Sol, Terra e Luna: da none a max |
| Limite temporale delle conoscenze | Astra: 30 aprile 2026 Sol: 20 aprile 2026 Luna: 18 maggio 2026 |
Tutti e tre: 16 febbraio 2026 |
Una finestra di 1,050,000 token non invita a inviare altrettanti token di input. I 922,000 token della tabella sono la differenza aritmetica riservando spazio all'output massimo, non un limite fisso di input attestato dalle attuali pagine ufficiali. Input, output e ragionamento devono trovare spazio nel contesto; la riserva effettiva dipende dalla richiesta. Conoscenze più recenti non garantiscono risposte migliori a ogni domanda. Per fatti variabili o attualità, fornisci fonti aggiornate e verifica la risposta. Il contesto è una capacità massima supportata, non una raccomandazione di usare prompt molto lunghi, che possono costare diversamente.
Come scegliere l'intensità di ragionamento?
Il reasoning effort controlla quanta elaborazione il modello può dedicare al problema prima della risposta. Aumentarlo può far salire latenza e costo senza miglioramenti utili nei compiti semplici. GPT-6 Astra non supporta none; gli altri cinque modelli qui elencati sì.
| Livello | Compiti iniziali utili | Che cosa verificare |
|---|---|---|
| none o low | Classificazione, estrazione, piccole modifiche e attività sensibili alla latenza | Astra non può usare none |
| medium | Codice, scrittura, ricerca e uso di strumenti quotidiani | Una base pratica per il confronto |
| high o xhigh | Analisi difficili, attività estese, verifica e debug | Misurare se la qualità migliora |
| max | I compiti più difficili in cui prevale la qualità | Latenza e costo possono aumentare molto |
OpenAI suggerisce di provare input rappresentativi e mantenere il modello e il livello più leggeri che superano la soglia di qualità. Registra l'intensità insieme al nome del modello quando confronti i risultati.
L'opzione «High» di un'app non è una specifica intercambiabile con un valore API. Controlla modello e interfaccia esatti: il precedente GPT-6 Sol supporta none, mentre Astra e il più recente GPT-6.1 Sol no.
Come stimare il costo API?
Per testo non in cache, con tariffe Standard per prompt brevi e prima dei costi degli strumenti o dei supplementi regionali, usa la formula seguente. I token sono unità di elaborazione e non corrispondono uno a uno a caratteri o parole.
Costo stimato = token input ÷ 1,000,000 × tariffa input + token output ÷ 1,000,000 × tariffa output.
Per mantenere un confronto comune tra le edizioni linguistiche, ipotizziamo 100 richieste, ciascuna con 10,000 token di input e 2,000 token di output fatturabili. Il totale è un milione di token input e 200,000 output, non una singola richiesta enorme. Ogni chiamata rientra nella fascia breve, senza cache, strumenti o tentativi ripetuti. Sono ipotesi illustrative, non consumi osservati.
| Modello | Input + output | Costo illustrativo |
|---|---|---|
| GPT-6 Astra | US$ 10.00 + 10.00 | US$ 20.00 |
| GPT-6 Sol | US$ 2.00 + 2.00 | US$ 4.00 |
| GPT-6 Luna | US$ 0.10 + 0.10 | US$ 0.20 |
| GPT-5.6 Sol | US$ 4.00 + 4.00 | US$ 8.00 |
| GPT-5.6 Terra | US$ 2.00 + 2.40 | US$ 4.40 |
| GPT-5.6 Luna | US$ 0.20 + 0.24 | US$ 0.44 |
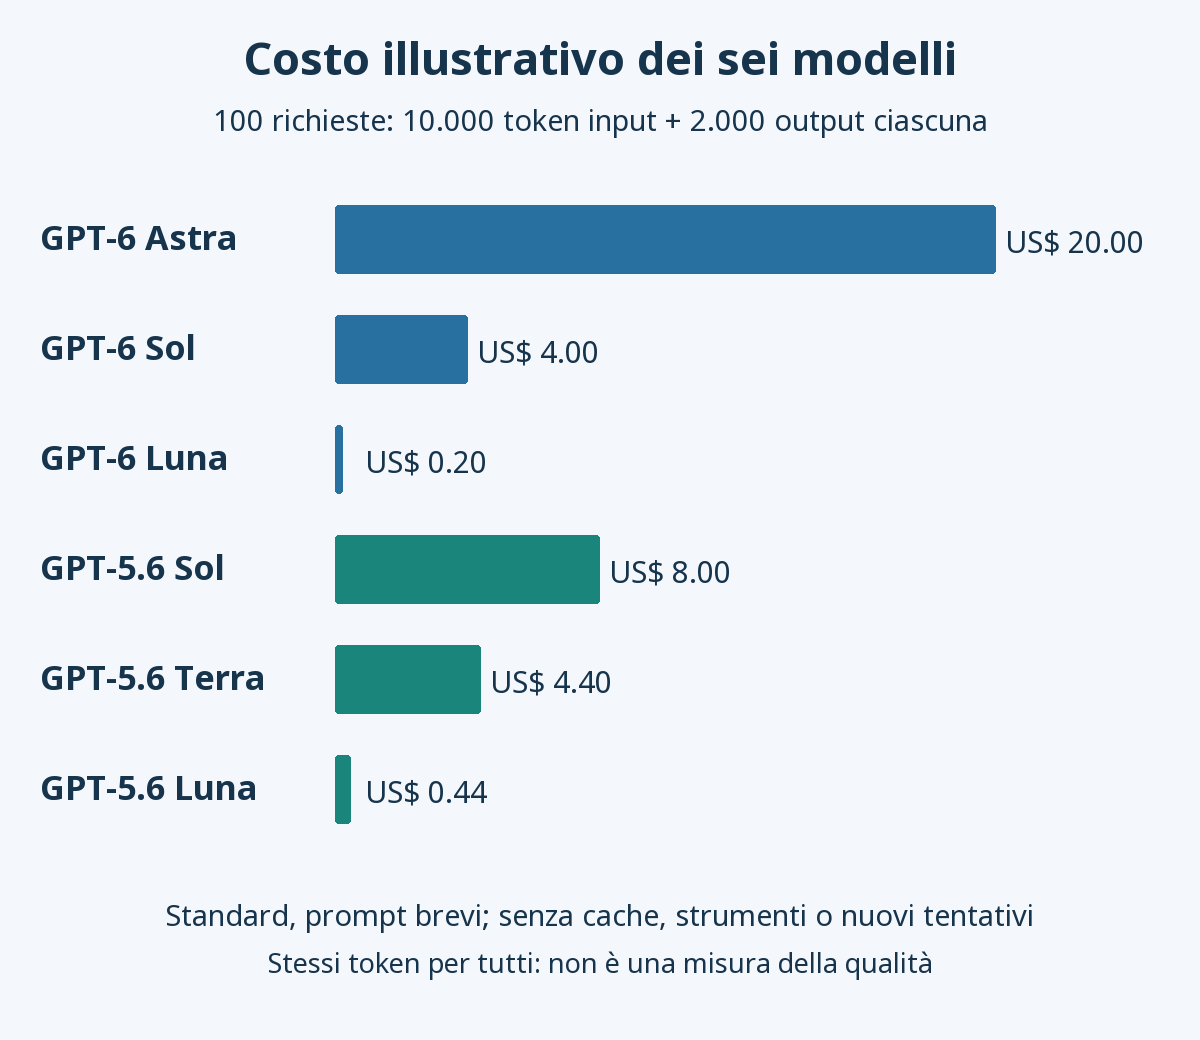
L'esempio mantiene costanti i token: non è una prova di qualità né una fattura reale. Più ragionamento, strumenti o tentativi possono cambiare il consumo. La documentazione ufficiale sul ragionamento spiega che i token di ragionamento invisibili sono fatturati come output. Sono già inclusi in usage.output_tokens: aggiungere di nuovo il dettaglio del ragionamento al totale li conterebbe due volte.
I prompt lunghi cambiano le tariffe. Tutte e sei le pagine indicano che oltre 272,000 token input si applicano il doppio della tariffa input e 1.5 volte quella output all'intera richiesta. Per GPT-6 Sol, una chiamata ipotetica con 300,000 token input e 2,000 output costa quindi 0.3 × US$4 + 0.002 × US$15 = US$1.23, prima di cache e strumenti, invece di US$0.62 alle tariffe brevi.
Letture e scritture della cache, Batch, Flex, Fast, elaborazione regionale, strumenti e nuovi tentativi possono modificare il totale. Il prezzo promozionale di GPT-5.6 Sol è documentato almeno fino al 21 novembre 2026: non presumere che sia permanente. Seleziona il livello di elaborazione applicabile nella pagina ufficiale dei prezzi quando prepari il budget.
Quale modello provare per il tuo caso d'uso?
| Situazione | Primo modello da provare | Motivo |
|---|---|---|
| Ricerca difficile, progettazione o attività agentiche lunghe | GPT-6 Astra | Punta a compiti ambigui con più strumenti |
| Scrittura professionale, codice e automazione quotidiana con limiti di spesa | GPT-6 Sol | Bilancia capacità e costo per token |
| Estrazione, classificazione e trasformazioni semplici su larga scala | GPT-6 Luna | Ha le tariffe Standard più basse qui indicate |
| Mantenere un flusso sul modello di punta GPT-5.6 | GPT-5.6 Sol | Conserva una base di valutazione consolidata |
| Mantenere una fascia intermedia GPT-5.6 | GPT-5.6 Terra | È l'opzione bilanciata nella famiglia 5.6 |
| Mantenere elaborazioni GPT-5.6 economiche ad alto volume | GPT-5.6 Luna | Include nel confronto il comportamento 5.6 esistente |
Sono candidati da valutare, non classifiche di prestazioni misurate. La scelta migliore dipende da input reali, criteri di accettazione, obiettivo di latenza e costo totale per compito completato.
Un metodo pratico per confrontare i modelli
Le specifiche pubblicate spiegano il ruolo previsto, ma un solo benchmark generico non può scegliere il modello per ogni flusso produttivo. Usa un piccolo insieme di valutazione rappresentativo:
- Raccogli compiti rappresentativi. Includi casi normali, informazioni mancanti, vincoli contrastanti, input lunghi ed errori noti. Definisci fatti richiesti e controlli di accettazione prima di vedere la risposta.
- Controlla le altre condizioni. Mantieni istruzioni, fonti, strumenti e formato. Parti da un livello supportato da tutti i candidati, poi prova separatamente quelli più leggeri. Non imporre un valore non supportato.
- Registra qualità e costo completo. Controlla correttezza, omissioni, formato e riuscita degli strumenti insieme a latenza, token di ogni chiamata, nuovi tentativi e tempo di correzione del revisore. Limita i permessi se la valutazione accede a sistemi o dati con conseguenze rilevanti.
- Usa criteri specifici per il compito. Per l'estrazione, verifica campi mancanti e valori non sostenuti. Per il codice, verifica requisiti e comportamento esistente. Un output più lungo o scorrevole non è di per sé migliore.
- Confronta il costo per risultato accettato. Chiamate economiche possono perdere il vantaggio dopo errori e revisioni. Un modello leggero per i casi ordinari, con passaggio a uno più forte in caso di incertezza o fallimento, è un'altra configurazione da valutare.
- Mantieni reversibili le modifiche. Registra modello e prompt precedenti e confronta un numero limitato di compiti prima di passare al nuovo sistema. Ripristina la configurazione se aumentano le regressioni. Ricontrolla casi rappresentativi quando cambiano alias, prezzi o strumenti.
Questo processo descrive una valutazione da svolgere nel tuo ambiente. Un modello più forte o un'intensità maggiore non rende affidabili fonti obsolete o prive di prove. Per ricerca e scrittura, affianca alla scelta la verifica delle informazioni dell'IA.