GPT-6 et GPT-5.6 : comparer Astra, Sol, Terra et Luna
GPT-6 Astra, Sol et Luna, ainsi que GPT-5.6 Sol, Terra et Luna, se distinguent par leur équilibre entre capacités, efficacité et coût d’utilisation par API. Évaluez Astra pour les travaux complexes et ouverts, GPT-6 Sol pour combiner capacités et budget, et GPT-6 Luna pour les tâches bien délimitées à grand volume. Le meilleur choix dépend du résultat réellement acceptable pour votre usage.
Dans la famille GPT-5.6, Sol est le modèle principal, Terra occupe le niveau intermédiaire et Luna vise les usages sensibles au coût. Le nom Sol ne désigne donc pas la même position dans les deux générations.
Périmètre : modèles d’API et abonnements sont distincts
Ce comparatif couvre gpt-6-astra, gpt-6-sol, gpt-6-luna et les trois modèles GPT-5.6. Une interface de programmation, ou API, permet à un logiciel d’appeler un modèle. La facturation des jetons, unités de contenu traitées par le modèle, est distincte des abonnements ChatGPT et Codex. Dans ces produits, les modèles accessibles, réglages et limites peuvent varier.
GPT-6.1 Sol est disponible en octobre 2026 : GPT-6 Sol n’est donc pas le plus récent modèle Sol. Nous conservons ici les six modèles pour comparer leurs usages ou une installation existante. Le guide de GPT-6.1 Sol et le guide officiel actuel présentent séparément son successeur.
Les rôles documentés servent de points de départ. Ils ne constituent pas un classement mesuré pour chaque tâche. Le guide officiel de sélection recommande de comparer des entrées identiques avec plusieurs modèles et réglages. Ses recommandations récentes ne doivent pas être attribuées automatiquement à l’ancien GPT-6 Sol.
Les six modèles en un tableau
| Modèle | Position dans sa famille | Usages à évaluer | Entrée | Sortie |
|---|---|---|---|---|
| GPT-6 Astra | Capacités les plus élevées | Raisonnement complexe, recherche, programmation, utilisation d’ordinateurs et livrables exigeants | 10,00 USD | 50,00 USD |
| GPT-6 Sol | Équilibre capacités et coût | Programmation courante, recherche, rédaction et travail avec des outils | 2,00 USD | 10,00 USD |
| GPT-6 Luna | Efficacité | Classement, extraction, transformations simples et automatisation à grand volume | 0,10 USD | 0,50 USD |
| GPT-5.6 Sol | Modèle principal de GPT-5.6 | Travaux professionnels complexes, code, interfaces et outils | 4,00 USD | 20,00 USD |
| GPT-5.6 Terra | Équilibre capacités et coût | Analyse intermédiaire, traitement documentaire et automatisation | 2,00 USD | 12,00 USD |
| GPT-5.6 Luna | Usages sensibles au coût | Extraction simple, classement, résumés et processus répétables | 0,20 USD | 1,20 USD |
Les prix sont exprimés en dollars américains par million de jetons textuels, en traitement Standard pour des requêtes courtes, sans frais d’outils. La lecture du cache, les contextes longs et les modes Batch, Flex ou Fast peuvent appliquer d’autres tarifs. Consultez les prix officiels de l’API avant de budgéter une charge réelle. Le tarif de GPT-5.6 Sol est promotionnel, annoncé au moins jusqu’au 21 novembre 2026.
Comment se répartissent Astra, Sol, Terra et Luna ?
GPT-6 utilise Astra, Sol et Luna pour ses niveaux de capacités, d’équilibre et d’efficacité. GPT-5.6 utilise Sol, Terra et Luna. OpenAI rapproche Terra de l’ancien niveau mini et Luna de l’ancien niveau nano. L’alias d’API gpt-5.6 pointe vers GPT-5.6 Sol.
| Rôle dans la famille | GPT-6 | GPT-5.6 |
|---|---|---|
| Capacités maximales | Astra | Sol |
| Niveau intermédiaire | Sol | Terra |
| Efficacité | Luna | Luna |
Une même ligne ne signifie pas une qualité, une vitesse ou des fonctions identiques entre générations. GPT-6 Sol est le modèle équilibré de GPT-6 ; GPT-5.6 Sol est le modèle principal de GPT-5.6.
GPT-6 Astra : les tâches complexes de bout en bout
Le modèle gpt-6-astra vise le raisonnement difficile, le développement logiciel, l’utilisation d’ordinateurs, la recherche et la création documentaire. C’est un candidat pertinent lorsqu’il faut coordonner plusieurs étapes, fichiers et outils avec des exigences incertaines.
- Projet dont les exigences incomplètes demandent un jugement attentif.
- Développement long couvrant conception, mise en œuvre et vérification.
- Recherche qui doit rapprocher des sources contradictoires et expliquer l’incertitude.
- Travail complexe entre documents, données, navigateurs et logiciels professionnels.
Astra affiche les tarifs unitaires les plus élevés de ce comparatif. Le guide des modèles GPT-6 rapporte néanmoins, dans certaines évaluations, de meilleurs résultats avec moins de jetons de sortie que des modèles antérieurs. Cela ne détermine pas votre facture : comparez le coût total par résultat accepté, avec les nouvelles tentatives et la révision.
GPT-6 Sol : combiner capacités et coût
gpt-6-sol cible la programmation complexe et les tâches d’agents à un prix unitaire inférieur à celui d’Astra. Il mérite un essai lorsque l’objectif est clair, mais que le travail exige encore jugement, outils et résultat soigné.
- Développement courant, débogage, revue de code et tests.
- Rédaction nécessitant recherche et vérification des sources.
- Travail entre tableaux, documents, navigateur et fichiers.
- Tâches à plusieurs étapes dont l’ambiguïté ne justifie pas le modèle le plus capable.
Parmi ces six modèles, Sol peut servir de référence lorsque le coût compte. Comparez Astra si des exigences importantes sont manquées et Luna si la tâche peut être mieux délimitée. Cette stratégie ne signifie pas que GPT-6 Sol soit le modèle par défaut actuel de tous les produits ; la documentation présente aussi le plus récent GPT-6.1 Sol.
GPT-6 Luna : les tâches ciblées à grand volume
gpt-6-luna privilégie l’efficacité pour des tâches délimitées. Ses tarifs d’entrée et de sortie sont les plus faibles des six modèles comparés.
- Extraction ou classement dans un format défini.
- Résumés courts, changement de style et préparation de métadonnées.
- Modifications limitées de fichiers et nettoyage de données.
- Préparation de brouillons qui seront ensuite relus individuellement.
Pour une tâche ambiguë ou sensible, les corrections humaines et les appels répétés peuvent annuler l’économie unitaire. Donnez des consignes précises, fixez le format et contrôlez les résultats selon des critères explicites. Un échantillon sert à évaluer la méthode, pas à considérer tous les contenus ultérieurs comme vérifiés.
GPT-5.6 Sol : le modèle principal de la génération 5.6
gpt-5.6-sol, également accessible par l’alias gpt-5.6, est présenté dans sa fiche officielle pour le travail professionnel complexe. Pour une nouvelle application, comparez aussi GPT-6 avant de le retenir.
Une installation existante peut avoir des consignes, évaluations et objectifs calibrés sur ce modèle. Comparez des tâches identiques selon la qualité, la latence, les jetons et les erreurs avant de changer le processus de production. La compatibilité doit être évaluée, sans justifier indéfiniment le maintien d’une ancienne version.
Testez les consignes, formats de sortie et interactions avec les outils. Un modèle plus récent ou moins coûteux peut réduire les dépenses s’il respecte les mêmes critères. Conservez l’ancienne configuration pendant cette vérification pour permettre un retour en arrière.
GPT-5.6 Terra : le niveau intermédiaire de GPT-5.6
gpt-5.6-terra équilibre capacités et coût, selon la fiche de Terra. Il correspond approximativement à l’ancien niveau mini.
Il peut convenir au traitement documentaire, à la rédaction, à l’analyse et à l’automatisation nécessitant davantage de jugement qu’une extraction simple. Aux tarifs Standard indiqués, son entrée coûte autant que celle de GPT-6 Sol et sa sortie davantage. Vérifiez donc compatibilité, qualité et délai avant de le choisir sur le seul argument du prix.
GPT-5.6 Luna : les traitements 5.6 sensibles au coût
La fiche de gpt-5.6-luna le destine aux grands volumes et le rapproche de l’ancien niveau nano. Il peut être évalué pour le classement, l’extraction et les résumés courts avec des critères de sortie clairs.
Les tarifs d’entrée et de sortie de GPT-6 Luna sont inférieurs dans le cas des requêtes courtes Standard présenté ici. Pour un nouveau traitement, testez donc aussi GPT-6 Luna ; gardez GPT-5.6 Luna comme référence lorsque le comportement d’une installation 5.6 existante compte.
Caractéristiques communes et différences utiles
| Caractéristique | GPT-6 | GPT-5.6 |
|---|---|---|
| Fenêtre de contexte | 1 050 000 jetons | 1 050 000 jetons |
| Sortie maximale | 128 000 jetons | 128 000 jetons |
| Exemple d’espace restant si 128 000 jetons sont réservés à la sortie | 922 000 jetons, par soustraction | 922 000 jetons, par soustraction |
| Images | Images en entrée ; texte en sortie | Images en entrée ; texte en sortie |
| Effort de raisonnement | Astra : low, medium, high, xhigh, maxSol et Luna : mêmes niveaux, avec none en plus |
Sol, Terra et Luna : none, low, medium, high, xhigh, max |
| Date limite des connaissances annoncée | Astra : 30 avril 2026 Sol : 20 avril 2026 Luna : 18 mai 2026 |
16 février 2026 pour les trois modèles |
La fenêtre de contexte comprend les informations traitées et l’espace nécessaire à la génération, y compris le raisonnement. Les 922 000 jetons ci-dessus résultent de 1 050 000 − 128 000 ; ce n’est pas une limite d’entrée indépendante annoncée dans les fiches. Les consignes, outils et autres éléments du contexte occupent aussi de la place.
Une date limite de connaissances plus récente ne prouve pas une meilleure réponse à toute question. Pour les actualités et les faits variables, fournissez une source actuelle et vérifiez le résultat. La capacité maximale du contexte n’est pas non plus une recommandation d’envoyer systématiquement de très longues entrées, dont la tarification peut différer.
Choisir l’effort de raisonnement
L’effort de raisonnement règle les ressources consacrées à la résolution du problème avant la réponse. L’augmenter peut accroître le délai et le coût sans bénéfice utile sur une tâche simple. Astra ne prend pas en charge none ; les cinq autres modèles de ce comparatif le permettent.
| Valeur | Tâches de départ possibles | Contrôle |
|---|---|---|
none ou low |
Classement, extraction, petites modifications et délai court | none est indisponible sur Astra. |
medium |
Code, rédaction, recherche et outils courants | Une base de comparaison à tester. |
high ou xhigh |
Analyse difficile, tâches longues, vérification et débogage | Mesurer le gain réel de qualité. |
max |
Tâches les plus difficiles lorsque la qualité prime | Délai et coût peuvent fortement augmenter. |
Évaluez des entrées représentatives et retenez le modèle et l’effort les plus légers qui respectent votre niveau de qualité. Consignez le réglage avec le nom du modèle. Un bouton « High » dans une application et une valeur d’API ne sont pas des spécifications interchangeables : vérifiez l’interface et le modèle exacts. Par exemple, l’ancien GPT-6 Sol accepte none, contrairement à Astra et au plus récent GPT-6.1 Sol.
Calculer un coût d’API
Pour du texte sans cache, en mode Standard et avec des requêtes courtes, l’estimation avant outils et suppléments régionaux est :
Coût estimé = jetons d’entrée ÷ 1 000 000 × tarif d’entrée + jetons de sortie ÷ 1 000 000 × tarif de sortie.
Un jeton ne correspond pas systématiquement à un mot ou à un caractère. Prenons 100 requêtes distinctes de 10 000 jetons d’entrée et 2 000 jetons de sortie facturables chacune. Le total est d’un million de jetons d’entrée et de 200 000 en sortie. Il ne s’agit pas d’une seule requête géante : chaque appel reste dans le tarif court. Le calcul suppose l’absence de cache, d’outils et de nouvelles tentatives. Ces volumes sont des hypothèses illustratives, pas des usages observés.
| Modèle | Entrée + sortie | Total illustratif |
|---|---|---|
| GPT-6 Astra | 10,00 + 10,00 USD | 20,00 USD |
| GPT-6 Sol | 2,00 + 2,00 USD | 4,00 USD |
| GPT-6 Luna | 0,10 + 0,10 USD | 0,20 USD |
| GPT-5.6 Sol | 4,00 + 4,00 USD | 8,00 USD |
| GPT-5.6 Terra | 2,00 + 2,40 USD | 4,40 USD |
| GPT-5.6 Luna | 0,20 + 0,24 USD | 0,44 USD |
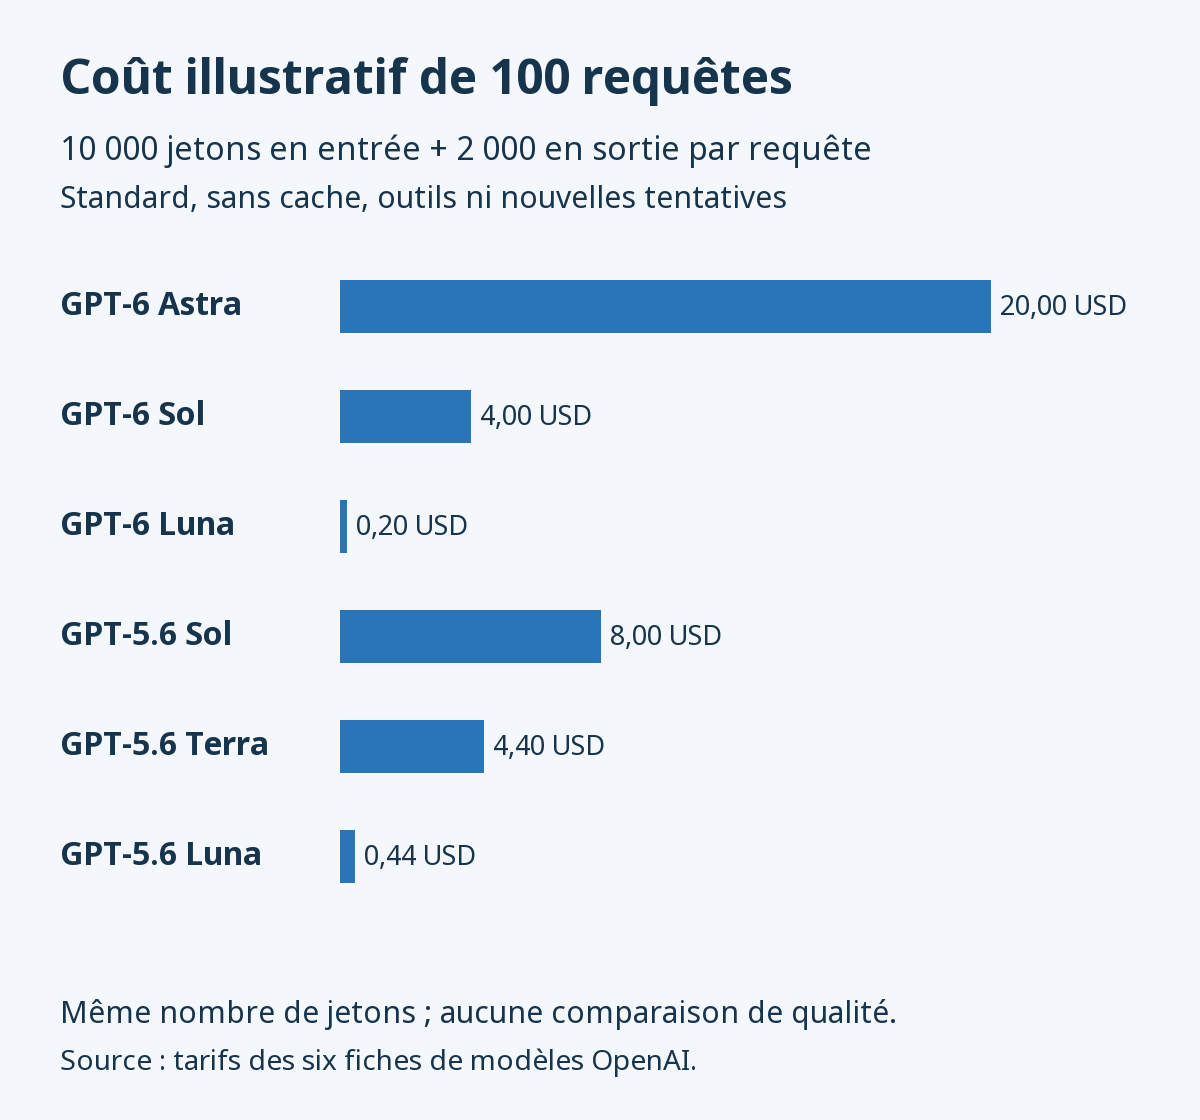
Le nombre de jetons est constant dans cet exemple. Il ne s’agit ni d’un test de qualité ni d’une facture réelle. Raisonnement, outils et reprises modifient la consommation. La documentation du raisonnement explique que les jetons de raisonnement non visibles sont facturés en sortie. Ils sont déjà inclus dans usage.output_tokens : ajouter une seconde fois le détail du raisonnement compterait ces jetons en double.
Les longues entrées changent le tarif applicable. Les fiches des six modèles indiquent qu’au-delà de 272 000 jetons d’entrée, l’ensemble de la requête utilise un tarif d’entrée doublé et un tarif de sortie multiplié par 1,5. Avec GPT-6 Sol, une requête hypothétique de 300 000 jetons d’entrée et 2 000 en sortie coûte donc 0,3 × 4 USD + 0,002 × 15 USD = 1,23 USD, hors cache et outils, au lieu de 0,62 USD au tarif court.
Lecture et écriture du cache, Batch, Flex, Fast, traitement régional, outils et nouvelles tentatives peuvent modifier le total. Le tarif promotionnel de GPT-5.6 Sol est annoncé au moins jusqu’au 21 novembre 2026 : ne le supposez pas permanent. Sélectionnez les conditions applicables dans la page officielle de tarification pour votre budget.
Quel modèle essayer selon la situation ?
| Situation | Premier candidat | Motif |
|---|---|---|
| Recherche, conception ou tâche d’agent longue et difficile | GPT-6 Astra | Travail ambigu mobilisant plusieurs outils. |
| Rédaction professionnelle, code et automatisation courante sous contrainte de budget | GPT-6 Sol | Équilibre entre capacités et tarif. |
| Extraction, classement et transformations simples à grande échelle | GPT-6 Luna | Tarifs Standard les plus faibles ici. |
| Maintenance d’un processus basé sur le modèle principal 5.6 | GPT-5.6 Sol | Référence d’évaluation déjà établie. |
| Maintien du niveau intermédiaire de GPT-5.6 | GPT-5.6 Terra | Option équilibrée de cette famille. |
| Maintien d’un traitement 5.6 à faible coût et grand volume | GPT-5.6 Luna | Comparaison avec le comportement existant. |
Ce sont des candidats à tester, pas un classement de performances mesurées. Le choix dépend des entrées réelles, des critères d’acceptation, du délai visé et du coût complet de chaque tâche terminée.
Comparer les modèles de manière pratique
Les spécifications expliquent le rôle prévu, mais un résultat générique ne choisit pas le modèle de tous les processus de production. Constituez un petit ensemble représentatif :
- Rassemblez des tâches variées. Incluez cas courants, informations manquantes, contraintes contradictoires, longues entrées et échecs connus. Définissez les faits ou vérifications obligatoires avant de lire les réponses.
- Stabilisez les autres conditions. Utilisez les mêmes consignes, sources, outils et formats. Commencez par un effort commun pris en charge, puis testez les réglages plus légers individuellement. N’imposez pas une valeur indisponible.
- Notez qualité et coût complet. Contrôlez exactitude, omissions, format et réussite des outils, ainsi que délai, jetons de chaque appel, nouvelles tentatives et temps de correction humaine. Limitez les autorisations si l’essai accède à des systèmes ou données sensibles.
- Adaptez les critères à la tâche. Pour une extraction, vérifiez champs absents et valeurs non étayées. Pour une modification de code, contrôlez exigences et comportements existants. Une réponse plus longue ou fluide n’est pas automatiquement meilleure.
- Calculez le coût par résultat accepté. Un appel bon marché peut perdre son avantage avec les erreurs et la révision. Évaluez aussi une organisation qui utilise un modèle léger pour les cas ordinaires et un modèle plus capable pour les cas incertains.
- Gardez une possibilité de retour. Enregistrez l’ancien modèle et ses consignes, comparez d’abord un ensemble limité, puis revenez à l’ancienne configuration si les régressions augmentent. Recontrôlez les cas représentatifs lorsque les alias, tarifs ou outils changent.
Cette démarche décrit une évaluation à mener dans votre environnement. Aucun modèle plus capable ni effort supérieur ne transforme une source périmée ou insuffisante en information fiable. Pour la recherche et la rédaction, associez le choix du modèle à la vérification des informations produites par l’IA.