GPT-6 与 GPT-5.6 对比:六款模型的用途、推理设置和 API 成本
GPT-6 Astra、Sol、Luna 与 GPT-5.6 Sol、Terra、Luna 的主要区别,在于能力、效率和 API(应用程序编程接口,使软件能够与服务通信) 成本之间的取舍。最困难、要求尚不完全明确的任务可先评估 GPT-6 Astra;需要平衡能力与费用时测试 GPT-6 Sol;范围明确、调用量大的工作可从 GPT-6 Luna 开始。
在 GPT-5.6 家族中,Sol 是旗舰,Terra 平衡智能与成本,Luna 面向成本敏感的任务。同样叫 Sol,并不意味着 GPT-6 Sol 和 GPT-5.6 Sol 在各自家族里处于相同位置。
比较范围:OpenAI API 模型,而非订阅套餐
本文比较 gpt-6-astra、gpt-6-sol、gpt-6-luna 和三款 GPT-5.6 模型。这里的 token 价格与 ChatGPT、Codex 订阅费分开计算;这些产品中的模型权限、推理选项和使用限额也可能不同。
到 2026 年 10 月,GPT-6.1 Sol 已经推出,因此不能把 GPT-6 Sol 当作最新 Sol。本文仍保留六款模型的比较,便于评估这些模型或维护现有系统。其后继型号另见 GPT-6.1 Sol 介绍及最新官方模型指南。
文档中的定位是评估起点,并非每种工作负载的实测排名。官方模型选择指南建议用相同输入比较不同模型和推理设置。该指南中针对较新型号的建议,不能自动套用到旧款 GPT-6 Sol。
六款模型概览
| 模型 | 家族内定位 | 可优先测试的任务 | 输入价格 | 输出价格 |
|---|---|---|---|---|
| GPT-6 Astra | 最高能力 | 复杂推理、研究、编程、计算机操作和高要求交付物 | $10.00 | $50.00 |
| GPT-6 Sol | 能力与成本平衡 | 日常编程、研究、写作和使用工具的流程 | $2.00 | $10.00 |
| GPT-6 Luna | GPT-6 中最重效率 | 分类、提取、简单转换和高频自动化 | $0.10 | $0.50 |
| GPT-5.6 Sol | GPT-5.6 旗舰 | 复杂专业工作、编程、前端开发和工具调用 | $4.00 | $20.00 |
| GPT-5.6 Terra | 智能与成本平衡 | 中等复杂度分析、文档处理和自动化 | $2.00 | $12.00 |
| GPT-5.6 Luna | GPT-5.6 的低成本选项 | 简单提取、分类、摘要和可重复流程 | $0.20 | $1.20 |
表中价格来自六款模型的官方页面,单位为每百万文本 token 的美元价格,适用于 Standard 标准处理的短提示词,不含工具费用。缓存输入、长上下文、Batch、Flex 和 Fast 可能使用不同费率。部署前应查看当前 OpenAI API 价格页。
Astra、Sol、Terra、Luna 如何对应?
GPT-6 家族由 Astra、Sol、Luna 构成:Astra 面向最苛刻任务,Sol 平衡能力与成本,Luna 强调效率。GPT-5.6 则用 Sol、Terra、Luna 分别代表旗舰、平衡和高效档位。OpenAI 将 GPT-5.6 Terra 描述为大致对应早期 mini 档位,GPT-5.6 Luna 大致对应早期 nano 档位。API 别名 gpt-5.6 指向 GPT-5.6 Sol。
| 家族内角色 | GPT-6 | GPT-5.6 |
|---|---|---|
| 最高能力 | Astra | Sol |
| 平衡档位 | Sol | Terra |
| 效率档位 | Luna | Luna |
这张表描述各家族内部角色,不表示同一行的跨代模型在质量、速度或功能上相等。特别是 GPT-6 Sol 是 GPT-6 的平衡选项,而 GPT-5.6 Sol 是 GPT-5.6 的旗舰。
GPT-6 Astra:最困难的端到端工作
模型 ID 为 gpt-6-astra。OpenAI 将 Astra 定位为能力最强的模型,用于复杂推理、软件工程、计算机操作、研究和文档创建。当任务需要跨文件、跨工具执行多步操作,且要求存在不确定性时,可将它作为优先评估的强能力候选。
- 要求不完整、需要审慎判断的项目
- 覆盖设计、实现和验证的长编程流程
- 需要协调冲突来源、解释不确定性的研究
- 涉及文档、数据、浏览器和专业软件的复杂工作
Astra 的标示 token 单价在本文六款中最高。不过,GPT-6 模型指南称,在部分评估中,它用更少输出 token 获得了优于早期模型的结果。这不能直接确定你的任务成本:应比较每个合格结果的总费用,包括重试和审核。
GPT-6 Sol:平衡能力与成本
模型 ID 为 gpt-6-sol。它面向复杂编程和智能体流程,也就是由模型借助工具推进一系列操作,标示 token 单价低于 Astra。当目标清楚,但仍需判断、工具使用和完善输出时,值得测试 Sol。
- 常规功能开发、调试、代码审查和测试
- 需要研究和核对来源的写作
- 跨电子表格、文档、浏览器和文件的流程
- 需要多步完成、但模糊程度尚不要求最强模型的任务
在本文六款范围内,Sol 可以成为重视费用时的实用基线。若遗漏重要要求,可比较 Astra;任务更狭窄时,可测试 Luna 能否以更低成本达标。这是评估策略,不是说 GPT-6 Sol 仍是所有产品的当前默认模型。现行官方编程文档也介绍了更新的通用型号 GPT-6.1 Sol。
GPT-6 Luna:高效处理明确的大批量任务
模型 ID 为 gpt-6-luna。OpenAI 将其描述为面向聚焦、高频任务的最高效 GPT-6 模型。在本文六款中,它的标示输入和输出 token 价格最低。
- 按指定格式提取、分类信息
- 简短摘要、风格转换和元数据生成
- 范围受限的文件修改和数据清理
- 批量生成交由人工审核的初稿
面对模糊或高影响任务,重试和人工修正的成本可能超过低单价的优势。应给 Luna 范围明确的指令,规定输出格式,并按清楚的质量标准抽查结果。
GPT-5.6 Sol:GPT-5.6 旗舰
模型 ID 为 gpt-5.6-sol,别名 gpt-5.6 也会路由到它。官方模型页将其定位为处理复杂专业工作的 GPT-5.6 旗舰。
新应用在选择 GPT-5.6 Sol 前,应先比较 GPT-6 模型。不过,现有应用的提示词、评估和运行目标可能已针对 GPT-5.6 Sol 调整。改变生产流程前,用相同任务比较质量、延迟、token 用量和失败率。
兼容性是需要评估的问题,不是无限期保留旧模型的理由。检查现有提示词、输出结构和工具流程有无回归。如果新模型或更便宜的模型满足相同验收标准,可能减少运行成本;验证切换期间应保留旧配置。
GPT-5.6 Terra:5.6 工作负载的中间档位
模型 ID 为 gpt-5.6-terra。Terra 官方页面强调智能与成本平衡,大致对应早期 GPT-5 mini 档位。
对于比简单提取更需要判断的文档处理、内容生成、分析和自动化,Terra 可以成为候选。但按表中的 Standard 费率,它的输入价格与 GPT-6 Sol 相同,输出价格更高。不要只凭价格选择,应先测试现有系统兼容性、回答质量和延迟。
GPT-5.6 Luna:注重成本的 5.6 流程
模型 ID 为 gpt-5.6-luna。Luna 官方页面将其定位于成本敏感的大批量任务,大致对应早期 nano 档位。
它适合列入分类、提取和短摘要的评估候选,前提是输出标准明确。按表中的短提示词 Standard 费率,GPT-6 Luna 的输入和输出价格均低于 GPT-5.6 Luna。新工作负载可优先评估 GPT-6 Luna;需要兼容现有 5.6 系统时,再保留 GPT-5.6 Luna 作比较。
共同规格与有意义的差别
| 规格 | GPT-6 家族 | GPT-5.6 家族 |
|---|---|---|
| 上下文窗口 | 1,050,000 token | 1,050,000 token |
| 预留最大输出后的算术剩余空间 | 922,000 token | 922,000 token |
| 最大输出 | 128,000 token | 128,000 token |
| 图像模态 | 图像输入;文本输出 | 图像输入;文本输出 |
| 推理强度 | Astra:low 至 max Sol、Luna:none 至 max |
Sol、Terra、Luna:none 至 max |
| 知识截止日期 | Astra:2026 年 4 月 30 日 Sol:2026 年 4 月 20 日 Luna:2026 年 5 月 18 日 |
三款均为 2026 年 2 月 16 日 |
1,050,000 token 的上下文窗口,不代表建议发送同等长度的输入。表中 922,000 是预留最大输出空间后的算术差额,并非当前官方模型页确认的固定输入上限。输入、输出与推理需要共享上下文,实际预留量取决于请求。知识截止日期更晚,也不保证每个问题表现更好。遇到新闻或变化中的事实,应接入最新来源并核实答案。上下文大小是支持的最大容量,不是使用超长提示词的建议;长输入还可能采用不同价格。
如何选择推理强度?
推理强度(reasoning effort)控制模型在给出答案前可用于分析问题的计算量。提高强度可能增加延迟和费用,却未必改善简单任务的质量。GPT-6 Astra 不支持 none,本文另外五款模型支持。
| 强度 | 可先尝试的任务 | 检查重点 |
|---|---|---|
| none 或 low | 分类、提取、小修改和延迟敏感任务 | Astra 不能用 none |
| medium | 日常编程、写作、研究和工具使用 | 适合作为比较基线 |
| high 或 xhigh | 困难分析、长任务、验证和调试 | 测量质量是否确实提升 |
| max | 质量优先的最困难任务 | 延迟和成本可能明显增加 |
OpenAI 的选择建议是使用代表性输入进行测试,保留能够达到质量门槛的最轻模型和推理设置。比较结果时,应同时记录模型名称和推理强度。
应用中的“High”选项与 API 强度值不是可直接互换的规格。应确认具体模型和接口。例如,旧款 GPT-6 Sol 支持 none,而 Astra 和更新的 GPT-6.1 Sol 不支持。
如何估算 API 成本?
对于 Standard 短提示词费率下的非缓存文本,可用以下公式估算,不含工具费用和地区处理附加费。token 是模型处理单位,与字、字符或单词并非一一对应。
估算费用 = 输入 token ÷ 1,000,000 × 输入单价 + 输出 token ÷ 1,000,000 × 输出单价。
为保持各语言版本的统一比较,假设共 100 次请求,每次使用 10,000 输入 token 和 2,000 计费输出 token。合计为一百万输入和 200,000 输出,而不是一次超大请求。每次都属于短提示词档位,不使用缓存、工具,也不重试。这些是演示假设,不是观察到的实际用量。
| 模型 | 输入 + 输出 | 演示费用 |
|---|---|---|
| GPT-6 Astra | US$ 10.00 + 10.00 | US$ 20.00 |
| GPT-6 Sol | US$ 2.00 + 2.00 | US$ 4.00 |
| GPT-6 Luna | US$ 0.10 + 0.10 | US$ 0.20 |
| GPT-5.6 Sol | US$ 4.00 + 4.00 | US$ 8.00 |
| GPT-5.6 Terra | US$ 2.00 + 2.40 | US$ 4.40 |
| GPT-5.6 Luna | US$ 0.20 + 0.24 | US$ 0.44 |
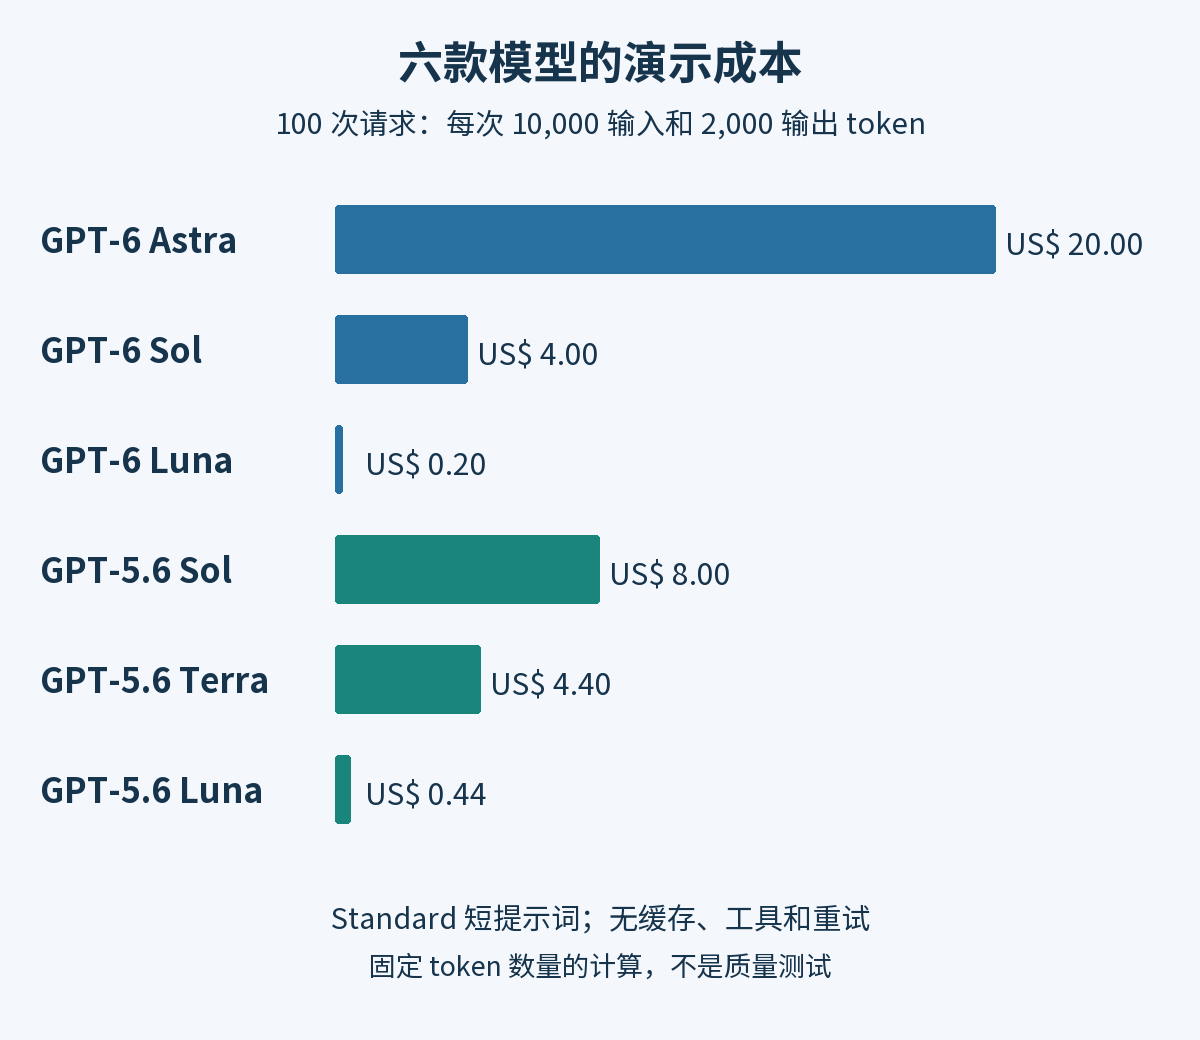
例子固定了 token 数量,不是质量基准测试,也不是真实账单。更多推理、工具调用或重试都会改变消耗。官方推理文档说明,不可见的推理 token 按输出计费,已经包含在 usage.output_tokens 中;再把推理明细加到这个总数上,会重复计算。
长提示词会改变适用费率。六款模型页面都说明:输入超过 272,000 token 时,整次请求的输入单价翻倍、输出单价为 1.5 倍。例如,GPT-6 Sol 单次请求假设使用 300,000 输入和 2,000 输出 token,费用为 0.3 × US$4 + 0.002 × US$15 = US$1.23,尚未考虑缓存或工具,而不是用短提示词费率算出的 US$0.62。
缓存读写、Batch、Flex、Fast、地区处理、工具和重试也会改变总额。GPT-5.6 Sol 的促销价格注明至少持续至 2026 年 11 月 21 日,不应视为永久价格。预算时,请在官方价格页选择适用的处理档位。
不同用途应先测试哪款模型?
| 场景 | 优先测试 | 理由 |
|---|---|---|
| 困难研究、设计或长时间智能体工作 | GPT-6 Astra | 面向要求模糊、多工具任务 |
| 预算有限的专业写作、编程和日常自动化 | GPT-6 Sol | 平衡能力与标示 token 成本 |
| 大规模提取、分类和简单转换 | GPT-6 Luna | 本文 Standard token 单价最低 |
| 维护 GPT-5.6 旗舰流程 | GPT-5.6 Sol | 保留已有评估基线 |
| 维护 GPT-5.6 中间档位 | GPT-5.6 Terra | 5.6 家族的平衡选项 |
| 维护低成本、高频 GPT-5.6 处理 | GPT-5.6 Luna | 把现有 5.6 行为保留为比较对象 |
这些是评估候选,不是实测性能排名。最佳选择取决于真实输入、验收标准、延迟目标,以及每项完成任务的全部成本。
实际比较模型的方法
公开规格说明预期定位,但一个通用基准不能为所有生产流程选定模型。可使用规模较小、具有代表性的评估集:
- 收集代表性任务。包含正常情况、信息缺失、约束冲突、长输入和已知失败。看到回答前,先确定必需事实或验收检查。
- 控制其他条件。保持指令、来源、工具和输出格式相同。先用候选共同支持的推理强度,再分别测试更轻设置。不要强制使用模型不支持的值。
- 记录质量和完整成本。检查正确性、遗漏、格式和工具成功情况,同时记录延迟、每次请求的 token、重试及审核修正时间。如果评估会访问有重要后果的系统或数据,应限制权限。
- 按任务设定通过标准。提取任务检查字段缺失和无依据的值;代码修改检查需求和既有行为。输出更长、更流畅不代表结果更好。
- 比较每个合格结果的成本。便宜的单次调用可能因失败与审核失去优势。普通任务使用轻模型,遇到不确定或失败时升级,是另一种值得评估的配置。
- 保持可回退。记录旧模型和提示词配置,先比较有限任务再切换;若回归增多,恢复旧设置。别名、价格或工具行为改变时,重新检查代表性案例。
这套流程描述的是应在自己环境中执行的评估。更强模型或更高推理强度,不能让过时、缺乏支持的材料变可靠。研究和写作时,应把 AI 信息事实核查与模型选择一并考虑。