Google Search Console:如何检查博客文章是否已编入索引
要确认博客文章是否已被 Google 编入索引,可以使用 Google Search Console 的网址检查工具。检查文章的公开网址后,查看索引编制状态、上次抓取时间以及 Google 选择的规范网址。被编入索引与针对某个搜索词获得显眼的展示位置,是两件不同的事。
准备要检查的网址
索引编制是分析网页并保存相关信息,以供搜索使用的过程。抓取则是此前获取网页的步骤,因此抓取成功不代表一定会编入索引。先选择一篇文章,复制它实际对外公开的网址。编辑器地址或预览地址不能反映已发布文章的索引状态。
在 Search Console 中选择涵盖该网址的网站资源。以浏览器中的最终网址为准,避免混淆 http 与 https,或带 www 与不带 www 的版本。如果无法访问合适的资源,需要验证所有权后添加资源,或向现有所有者申请访问权限。
网址前缀资源只涵盖以登记的协议、主机和路径开头的网址。例如,https://example.com/ 不包含 https://www.example.com/。网域资源 example.com 则涵盖其子网域和多种协议。如果工具提示网址不属于当前资源,先核对地址与资源范围。具体区别可参阅 Google 关于资源类型及覆盖范围的说明。
例如,旧文章的网址重定向到了新页面,应先检查新页面,把旧地址作为单独的重定向检查对象。先明确一个希望公开并被收录的最终网址,排查过程会更清晰。
检查一篇博客文章
- 在 Search Console 中选择对应的网站资源。
- 将完整的公开地址粘贴到顶部的网址检查栏,运行检查。
- 阅读索引状态结果,并展开网页索引编制详情。
- 记录上次抓取时间、网页抓取结果、是否允许编入索引,以及规范网址信息。
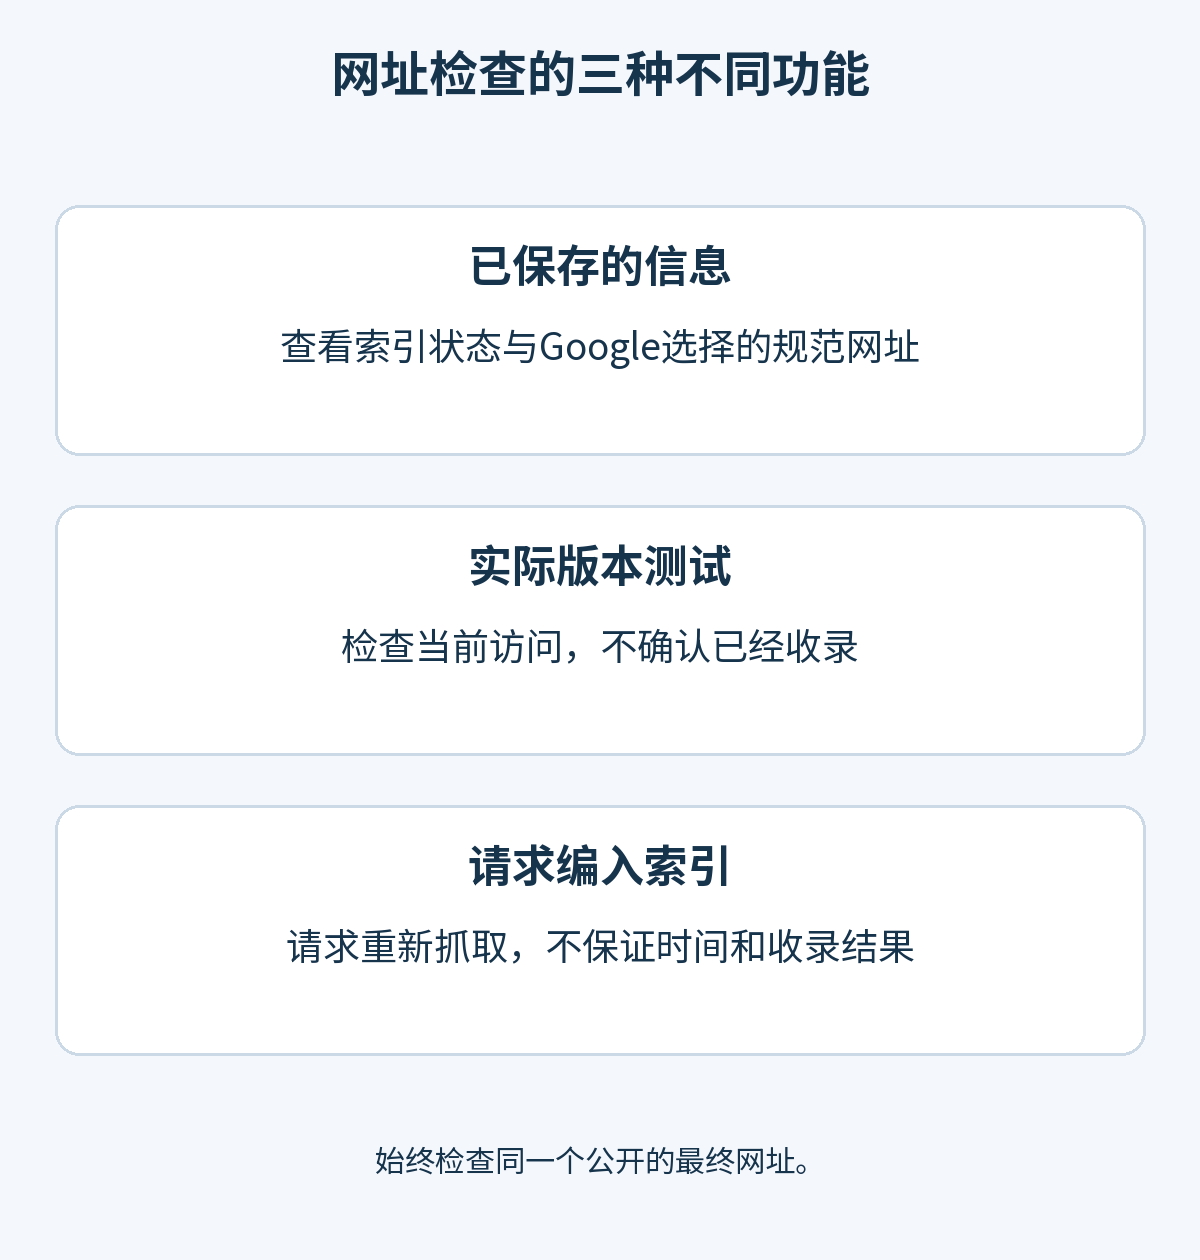
最初显示的报告使用 Google 已保存的信息,并不是对当前网页重新进行的测试。“网址已收录到 Google”表示网页具备出现在搜索结果中的资格,不保证每个查询都能看到它。各字段的含义可查看 网址检查工具官方说明。
规范网址是相同或相似网页的代表地址。“用户声明的规范网址”是网站表达的偏好,“Google 选择的规范网址”则是 Google 的选择,两者可能不同。应对照被检查的页面、网站声明的地址和 Google 选定的页面,同时查看内容与重定向关系。声明规范网址并不能强制 Google 采用它。
记录时应将具体原因与被检查的地址放在一起,而不只是写“未收录”。这样再次检查时,就能分辨是状态发生了变化,还是检查了另一个网址版本。
理解网页未编入索引的原因
要查看整个网站的情况,可进入索引编制 → 网页,选择一种原因并检查示例网址。不是所有被排除的网址都需要修复;应先判断它是否属于本来就应出现在搜索结果中的原创文章。
| 状态 | 含义与下一步检查 |
|---|---|
| 已发现,尚未编入索引 | Google 已知道该网址,但尚未抓取。检查公开访问是否正常,以及是否有内部链接指向它。 |
| 已抓取,尚未编入索引 | Google 已获取网页,但没有将其编入索引。之后可能收录,也可能不收录;不要求重新提交网址。应检查内容与重复情况,而不是反复请求。 |
| 备用网页,有适当的规范标记 | 另一个网址是预期的原始版本。如果对应关系正确,无需修改。 |
| 重复网页:Google 选择的规范网址与用户声明的不同 | Google 选择了另一个代表地址。对照两个规范网址和被检查页面,包括内容、内部链接与重定向关系。 |
| 被 noindex 标记排除 | 网页存在禁止编入索引的指令。先确认该原始页面是否应出现在搜索中,只移除非预期的排除指令,然后测试当前页面。 |
| 被 robots.txt 屏蔽 | 抓取受到限制。这不等同于从索引中排除,而且可能导致 Google 无法读取 noindex。检查这条规则是否有意设置。 |
| 未找到(404)或 Soft 404 | 页面已删除且没有替代内容时,返回 404 可以是正常的。如果文章仍应存在,应恢复正确地址及内容。区分真正的 404 与虽然显示内容不存在、却返回成功响应的页面。 |
| 网页会重定向 | 该网址把访问者带往其他地址。检查希望编入索引的最终目标页面。 |
网页索引编制报告说明介绍了这些原因的区别。试图让每个备用地址或重定向地址都被收录,通常不是合适的目标。
报告中的示例网址不保证覆盖所有情况。如果某篇重要文章没有出现在列表中,应直接检查它的准确网址。此外,仅凭“已抓取,尚未编入索引”这一状态,不能断定文章质量低下或网站受到了处罚。
实用的下一步是查看多篇重要文章是否具有相同的排除原因。如果只有一篇受影响,先检查该页面及其网址关系;如果涉及范围较广,再排查共用模板、设置或服务器访问情况。这可以缩小调查范围,但状态本身并不能证明具体原因。
检查希望出现在搜索中的页面设置
首先在未登录网站的情况下打开文章。Google 的最低要求包括允许抓取、返回成功响应以及提供可编入索引的内容;满足要求仍不保证收录。可以从 Google 搜索技术要求开始核对。
- 可见性:检查文章是否仍是草稿、私密内容或受密码保护的页面。只公开本来就要提供给读者的内容。
- 索引排除:检查 SEO 插件或响应头中是否有非预期的
noindex指令。SEO 插件比较与设置指南说明了这些工具管理哪些设置及输出。应继续保留不适合出现在搜索中的页面的排除设置。 - 规范网址:核对声明的地址是否为预期原始版本。不要将重复地址或带参数的网址与主文章混淆。
- 内部链接:确认相关文章或分类页链接到该文章。如果页面孤立,应在适当语境中补充一条对读者有用的链接。
robots.txt 控制抓取,noindex 请求排除索引。禁止抓取可能使 Google 看不到网页上的 noindex 指令。应参阅 noindex 的使用条件,只修改实际造成问题的设置。
在 WordPress 中,检查设置 → 阅读 → 搜索引擎可见性。要求搜索引擎不索引本站的选项,是请求搜索引擎排除索引,不会阻止普通访问者,也不提供密码保护。如果公开博客本应被索引,而该选项是误开的,可考虑取消勾选、保存,并检查已发布页面实际输出的索引指令。WordPress 阅读设置文档明确区分了这项功能与访问控制。
修改前先记录现有设置,修改后查看公开页面并重新检查网址。内部链接应是正常可访问的链接,并使用有说明意义的文字。Google 的可抓取链接指南说明了搜索引擎能够跟踪哪些链接。
实际网址测试通过,不代表已经收录
修改页面后,如需了解 Google 能否访问当前版本,可使用测试实际版本。将测试结果与已保存的索引信息对比。测试通过既不证明已经编入索引,也不证明会获得某种排名。
例如,网站已经移除了旧的排除指令,但存储的报告仍可能显示旧状态。应分别记录“当前阻碍已经解除”和“索引报告已经更新”。这样可以避免没有必要地反复调整设置。
实际版本测试无法预测 Google 最终选择哪个规范网址,也不能解决所有重复网页问题。它也不会检查所有影响展示的限制,例如人工处置措施、安全问题或移除请求。旧地址发生重定向时,测试可能跟随跳转,却不单独显示最终网址。直接检查希望收录的最终地址会更清楚。
请求编入索引并跟进结果
发布新文章或修复问题后,可以通过网址检查工具请求编入索引。操作需要所有者或完整用户权限。抓取可能耗时数天或数周,重复提交不会加快处理,也不保证最终收录。如果涉及很多网址,也应维护站点地图。具体做法可参阅 Google 关于请求重新抓取的指南。
- 检查预期的最终网址。确认它是已发布的原始页面,而不是旧地址或重复版本。
- 测试已经修改的问题。使用实际版本测试核对抓取结果及索引权限。先解决仍能检测到的阻碍,再请求重新抓取。
- 选择请求编入索引。请求已接收不等于索引编制已完成。如果达到提交配额,应稍后再试;有多个网址时可考虑站点地图,而不是反复点击。
- 稍后对比已保存的信息。记录被检查的网址、检查与请求时间、上次抓取时间、排除原因及所做修改。下次应对比同一个网址。
之后再次检查同一地址,对比上次抓取时间与排除原因。文章收录后,再查看搜索词的展示次数和点击情况。如果仍未编入索引,应继续处理尚未解决的访问、规范网址及内容问题,而不是增加请求次数。