Blog für die ChatGPT-Suche zugänglich machen: Crawler und robots.txt prüfen
Um Ihren Blog dazu zu bringen, über die ChatGPT-Suche entdeckt zu werden, prüfen Sie zunächst, ob OAI-SearchBot, der Suchcrawler von OpenAI, darauf zugreifen kann. Sein Zweck unterscheidet sich vom Trainings-Crawler GPTBot, sodass Sie separate Richtlinien für den Suchzugriff und die Sammlung für das Modelltraining festlegen können. Das Erlauben des Crawlerzugriffs garantiert nicht, dass eine bestimmte Antwort Ihre Website anzeigt oder zitiert.
Such- und Trainings-Crawler verstehen
Ein Crawler ist ein Programm, das Webseiten automatisch abruft. OpenAI verwendet verschiedene Benutzeragenten für unterschiedliche Zwecke, und Websitebesitzer können Zugriffsrichtlinien für diese Namen festlegen. Ein User Agent ist eine Information, die ein anforderndes Programm verwendet, um sich selbst zu identifizieren.
| Name | Hauptzweck | Was zu unterscheiden ist |
|---|---|---|
| OAI-SearchBot | Automatisierte Sammlung für ChatGPT-Suchergebnisse | Suchzugriffsrichtlinie |
| GPTBot | Sammlung von Inhalten, die zum Trainieren von Grundlagenmodellen verwendet werden können | Ob Sammlung für das Modelltraining erlaubt ist |
| ChatGPT-User | Besuche aufgrund von Benutzeranfragen | Verhalten unterscheidet sich von einem automatisierten Suchcrawler |
OpenAIs offizielle Crawler-Dokumentation erklärt, dass Such- und Trainingseinstellungen unabhängig sind. Es wird auch darauf hingewiesen, dass robots.txt-Regeln möglicherweise nicht für benutzerinitiierte Besuche gelten. Die Blockierung von GPTBot allein sollte nicht so verstanden werden, dass jede Art von ChatGPT-bezogenem Zugriff kontrolliert wird.
Die aktuelle Dokumentation unterscheidet Suchantworten von Navigationslinks: Seiten, die von OAI-SearchBot ausgeschlossen wurden, werden in den Suchantworten nicht angezeigt, können jedoch weiterhin als Links für die Navigation angezeigt werden. Ein sichtbarer Link allein belegt daher nicht, dass der Beitragstext erfolgreich gecrawlt wurde. Besuche mit ChatGPT-User bestimmen ebenfalls nicht, ob Inhalte für die Suche berücksichtigt werden dürfen.
Notieren Sie die aktuellen Einstellungen für den öffentlichen Zugang
Entscheiden Sie Ihre Richtlinien, bevor Sie die Einstellungen ändern: Sollte die Website bei der Suche auffindbar sein, sollte die Sammlung für das Modelltraining erlaubt sein und wo ist Material, das privat bleiben muss? Speichern Sie die aktuelle robots.txt und relevante Sicherheitskonfiguration, damit Sie sie bei Bedarf wiederherstellen können.
- Prüfen Sie im abgemeldeten Zustand, ob der Beitrag, den Sie entdecken möchten, zugänglich ist.
- Öffnen Sie
/robots.txtauf dem eigentlichen öffentlichen Schema und Host. Verwechseln Sie nicht den Umfang vonhttps://example.com/robots.txtmithttps://www.example.com/robots.txt. - Überprüfen Sie dedizierte OAI-SearchBot- und GPTBot-Gruppen sowie die Standardgruppe
User-agent: *, die verwendet wird, wenn ein Crawler keine übereinstimmende Gruppe hat. - Suchen Sie nach separaten Bot-Blockierungen im Host, Sicherheits-Plugins oder im Content Delivery Network (CDN).
Eine WordPress-Website kann robots.txt über eine physische Serverdatei, ein Plugin oder eine dynamisch generierte Antwort bedienen. Überprüfen Sie, ob Änderungen, die an der Administrationsoberfläche vorgenommen wurden, tatsächlich in die öffentliche Datei gelangen. Stellen Sie fest, welche Komponente die aktuelle Antwort verwaltet, anstatt davon auszugehen, dass ein bestimmtes Plugin installiert ist.
Lesen Sie ein Beispiel, das Suche erlaubt und Modelltraining ausschließt
Das folgende Beispiel ermöglicht den Suchzugriff auf öffentliche Inhalte, während die GPTBot-Sammlung deaktiviert wird. Es ist keine vollständige Ersatzdatei für jede Site. Bewahren Sie vorhandene Sitemap-Deklarationen und notwendige Einschränkungen auf und führen Sie dann die Regeln gemäß Ihrer Richtlinie zusammen.
User-agent: OAI-SearchBot
Allow: /
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-agent: GPTBot
Disallow: /
Diese Version enthält auch die gängige WordPress /wp-admin/-Beschränkung und admin-ajax.php-Ausnahme in der OAI-SearchBot-Gruppe. Überprüfen Sie, ob dies die Regeln sind, die Ihre Website benötigt. Ein spezifischerer Disallow kann immer noch neben Allow: / gelten. Disallow: / von GPTBot besagt, dass das Sammeln auf seinen Pfaden nicht erlaubt ist. Fügen Sie alle anderen notwendigen Ausschlüsse, wie Member-Only-Pfade, separat hinzu.
Gehen Sie nicht davon aus, dass eine dedizierte Gruppe die Einschränkungen unter User-agent: * erbt. Die Gruppenauswahlregeln des robots.txt-Standards verwenden die Standardgruppe, wenn keine übereinstimmende Agentengruppe existiert. Wenn die Standardgruppe bestimmte Pfade ausgeschlossen hat, überprüfen Sie, ob die erforderlichen Ausschlüsse auch in der OAI-SearchBot-Gruppe vorhanden sind. Schützen Sie privates Material mit Authentifizierung und Autorisierung unabhängig von diesen Regeln.
Das Beispiel kann wie folgt gelesen werden. Dies sind Regelinterpretationen, keine Beobachtungen von Anfragen von OpenAI-Servern:
- OAI-SearchBot auf einem gewöhnlichen öffentlichen Post: erlaubt, es sei denn, es gilt eine spezifischere Einschränkung.
- OAI-SearchBot unter
/wp-admin/: durch diese Einschränkung verboten. - OAI-SearchBot auf
/wp-admin/admin-ajax.php: die spezifischere Ausnahme gilt. - GPTBot auf Postpfaden: Die Trainingssammlung ist durch Richtlinien verboten.
RFC 9309 kombiniert die Regeln, wenn mehrere Gruppen mit dem gleichen Agenten übereinstimmen, und verwendet dann die spezifischste Übereinstimmungspfadregel. Interpretieren Sie die Datei nicht als "die letzte Zeile gewinnt immer".
Suchen Sie nach einer vorhandenen Gruppe für denselben Agenten und lösen Sie Duplikationen oder Widersprüche, bevor Sie speichern. Überprüfen Sie anschließend die Caches und öffnen Sie das öffentliche /robots.txt erneut, um die ausgelieferten Regeln mit Ihrer Absicht zu vergleichen. Wenn das Ergebnis unterschiedlich ist, stellen Sie die ursprüngliche Datei und die Einstellungen wieder her und untersuchen Sie den Verwaltungspfad.
OpenAI sagt, dass seine Systeme etwa 24 Stunden brauchen können, um sich an robots.txt-Änderungen anzupassen. Dies betrifft Updates der Zugriffsregeln; es verspricht keine Entdeckung oder Zitierung innerhalb von 24 Stunden.
Der Zugriff kann immer noch fehlschlagen, wenn robots.txt es erlaubt
Eine robots.txt-Berechtigung und der Server, der eine Anfrage akzeptiert, sind getrennte Angelegenheiten. Firewalls, Bot-Schutz, Anmeldeanforderungen oder Verbindungsfehler können das Abrufen verhindern. Wenn Ihre Tools Blockierungsprotokolle bereitstellen, überprüfen Sie die betroffene URL, Uhrzeit und Regelname.
Ein Content Delivery Network (CDN) liefert Inhalte über verteilte Server näher an den Besuchern aus und kann auch Bot-Regeln anwenden, bevor Anfragen den Host erreichen. Eine 403-Antwort, eine Anmeldeseite oder eine Herausforderung, die in ihren Protokollen angezeigt wird, kann daher eine Untersuchung über robots.txt hinaus erfordern.
Vermeiden Sie es, "den gesamten Bot-Schutz zu deaktivieren" den ersten Schritt zur Fehlerbehebung zu machen. Identifizieren Sie die spezifische Sperrregel und passen Sie nur den erforderlichen Umfang an. Eine Testanfrage mit einem geänderten User-Agent-Namen beweist nicht, dass sie von OpenAI stammt; Vergleichen Sie auch die veröffentlichten OAI-SearchBot IP-Bereiche mit den Request-Verifizierungsmethoden Ihres Providers. Verwenden Sie die aktuelle offizielle Liste, anstatt kopierte Beispiele als permanente Adressen zu behandeln.
Eine Seitenöffnung in Ihrem Browser garantiert nicht, dass ein Crawler die gleiche Antwort erhält. Umgekehrt stellt eine blockierte automatisierte Anforderung nicht fest, dass alle Leser oder Crawler blockiert sind. Notieren Sie, welche Anfrage getestet wurde und unter welchen Bedingungen.
Die Crawling-Richtlinie, die tatsächlich ausgelieferte Antwort und die Auswahl in der Suche erfordern unterschiedliche Prüfungen. Das Diagramm trennt sie, so dass eine Überprüfung zeigen kann, was festgelegt ist und was unsicher bleibt.
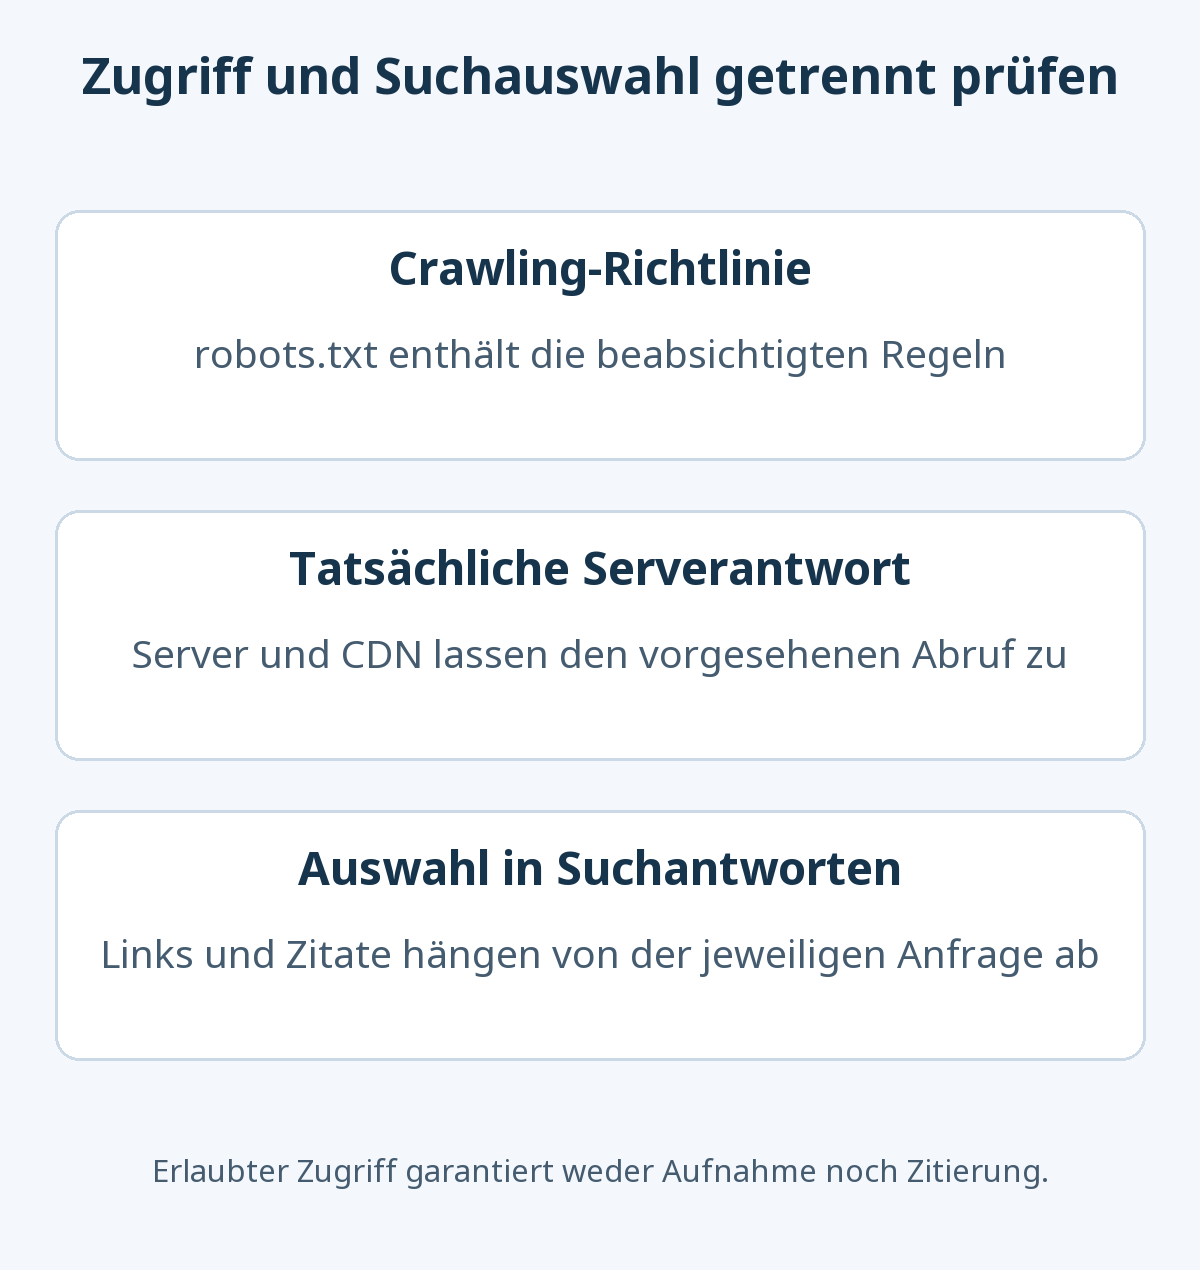
Zugriffskonfiguration von Suchsichtbarkeit trennen
Sobald der Zugriff konfiguriert ist, überprüfen Sie den Inhalt und die Linkstruktur der Seite. Ist die Hauptantwort öffentlich verfügbar? Können Leser es durch relevante Posts oder Kategorien erreichen? Passt der Titel zum Beitragstext? Die Freigabe des Suchzugriffs ist kein Schalter, der Ihren Link in jeder Antwort erscheinen lässt.
Halten Sie die Ergebnisse „robots.txt erreichbar“, „beabsichtigte Regeln ausgeliefert“, „öffentlicher Beitrag zugänglich“ und „in der Suche gefunden“ getrennt fest. Das letzte Ergebnis kann sich mit dem Wortlaut und dem Timing einer Abfrage ändern, so dass eine Suche nicht zuverlässig feststellen kann, ob die Konfiguration erfolgreich war oder nicht.
OpenAIs ChatGPT-Suchhilfe beschreibt auch die Berechtigung und das Fehlen einer garantierten Platzierung. Es werden vertrauenswürdige Server- oder CDN-Einträge benötigt, um den tatsächlichen Abruf zu überprüfen. Für die Inhaltsseite siehe die Rollen von SEO, AEO und GEO bei der Strukturierung nützlicher Inhalte (englisch). Überprüfen Sie Zugriffsprobleme getrennt davon, ob der Artikel eine zitierenswerte Antwort liefert.
Für die Google-Indexierung lesen Sie So überprüfen Sie den Indexierungsstatus eines Beitrags in der Search Console (englisch). Der Indexstatus von Google und die Sichtbarkeit der ChatGPT-Suche können nicht miteinander gleichgesetzt werden.
Verwenden Sie robots.txt nicht als Sicherheitsgrenze
Robots.txt ist eine öffentliche Erklärung der Crawling-Richtlinie, kein Authentifizierungsmechanismus für privates Material. Googles robots.txt Einführung erklärt auch, dass nicht jeder Crawler seinen Regeln folgt. Schützen Sie die Inhalte und administrativen Informationen der Mitglieder durch Authentifizierung und Berechtigungen.
Behalten Sie die geänderte Datei, die Sicherheitsregeln und die tatsächliche öffentliche Antwort zusammen, damit Sie wissen, was wiederhergestellt werden muss, wenn etwas schief geht. Legen Sie zuerst den öffentlichen Suchbereich und den geschützten privaten Bereich fest. So vermeiden Sie unnötig breite Freigaben, wenn Sie die Suchsichtbarkeit prüfen.