Como permitir que os rastreadores da busca do ChatGPT acessem seu blog
Para que um blog possa ser encontrado na busca do ChatGPT, confira primeiro o acesso do OAI-SearchBot, o rastreador de pesquisa da OpenAI. Ele tem uma finalidade diferente da coleta para treinamento do GPTBot, e as duas políticas podem ser definidas separadamente. Permitir o acesso não garante exibição nem citação em uma resposta específica.
Diferencie pesquisa, treinamento e visitas solicitadas
Um rastreador é um programa que busca páginas automaticamente. O campo User-Agent identifica o programa perante o servidor e permite ao responsável pelo site definir políticas por nome.
| Identificador | Finalidade | O que distinguir |
|---|---|---|
| OAI-SearchBot | Coleta para resultados da busca do ChatGPT. | Permissão de pesquisa. |
| GPTBot | Coleta que pode servir ao treinamento de modelos fundamentais. | Política de treinamento. |
| ChatGPT-User | Visitas iniciadas por solicitações de usuários. | Não é o rastreador automático de pesquisa. |
A documentação dos rastreadores da OpenAI explica a independência dessas escolhas. As regras de robots.txt podem não se aplicar às visitas iniciadas por usuários; ChatGPT-User não determina a elegibilidade para Search. Um site que recusa OAI-SearchBot não aparece nas respostas de pesquisa, mas ainda pode aparecer como link de navegação. Ver um link, portanto, não comprova que seu texto foi recuperado.
Registre a configuração pública antes de alterar
Defina a política pretendida: o conteúdo público poderá participar da pesquisa? A coleta para treinamento será permitida? Quais áreas devem permanecer privadas? Guarde o arquivo atual e as configurações relevantes para conseguir restaurá-los.
- Abra o artigo sem estar conectado ao WordPress e confirme que ele é público.
- Consulte
/robots.txtno protocolo e no host efetivamente utilizados.https://example.com/robots.txtehttps://www.example.com/robots.txttêm escopos diferentes. - Procure os grupos OAI-SearchBot e GPTBot e examine o grupo padrão
User-agent: *. - Verifique também possíveis bloqueios na hospedagem, em plugins de segurança e na rede de distribuição de conteúdo.
No WordPress, a resposta pode vir de um arquivo físico, de um plugin ou de geração dinâmica. Identifique qual componente controla o arquivo do seu site. Uma opção salva na administração não comprova que a mesma alteração chegou ao endereço público.
Registre a resposta recebida e o endereço completo consultado. Isso evita comparar arquivos de hosts diferentes ou tratar uma versão antiga do cache como se fosse a configuração nova. Não presuma que um plugin específico está instalado apenas porque um tutorial o utiliza.
Leia um exemplo que permite pesquisa e recusa treinamento
O exemplo abaixo permite a pesquisa do conteúdo público e recusa a coleta do GPTBot. Adapte-o à política do site: ele não deve substituir indiscriminadamente declarações de sitemap ou outras restrições existentes.
User-agent: OAI-SearchBot
Allow: /
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-agent: GPTBot
Disallow: /
A restrição /wp-admin/ e a exceção para admin-ajax.php ilustram um caso comum do WordPress; confira se correspondem ao seu ambiente. Uma regra mais específica pode limitar o alcance de Allow: /. Acrescente as outras exclusões necessárias, como caminhos reservados a membros.
Não suponha que o grupo específico herda as restrições do grupo User-agent: *. A RFC 9309, padrão do protocolo robots.txt, define o grupo padrão para quando não há correspondência com o agente. Reproduza no grupo dedicado as restrições que continuam necessárias.
A leitura deste exemplo é a seguinte; ela descreve regras, sem alegar observação de requisições reais da OpenAI:
- OAI-SearchBot em um artigo público: permitido, salvo outra restrição mais específica.
- OAI-SearchBot sob
/wp-admin/: proibido pela regra do exemplo. - OAI-SearchBot em
/wp-admin/admin-ajax.php: permitido pela exceção mais específica. - GPTBot nos artigos: coleta recusada pela política.
Segundo a RFC, grupos correspondentes ao mesmo agente são combinados e a correspondência de caminho mais específica prevalece. Não se trata de uma regra em que a última linha sempre vence. Procure grupos existentes e resolva duplicações antes de salvar.
Depois de ajustar o componente responsável, confira os caches e abra novamente o endereço público. Compare o conteúdo entregue com a política pretendida. Se a resposta for inesperada, restaure o arquivo e os parâmetros anteriores e investigue a origem da diferença.
A OpenAI informa cerca de 24 horas para seus sistemas se ajustarem a mudanças de robots.txt. Esse prazo diz respeito às regras de acesso; não promete descoberta ou citação em 24 horas.
A permissão no arquivo pode não bastar para receber a página
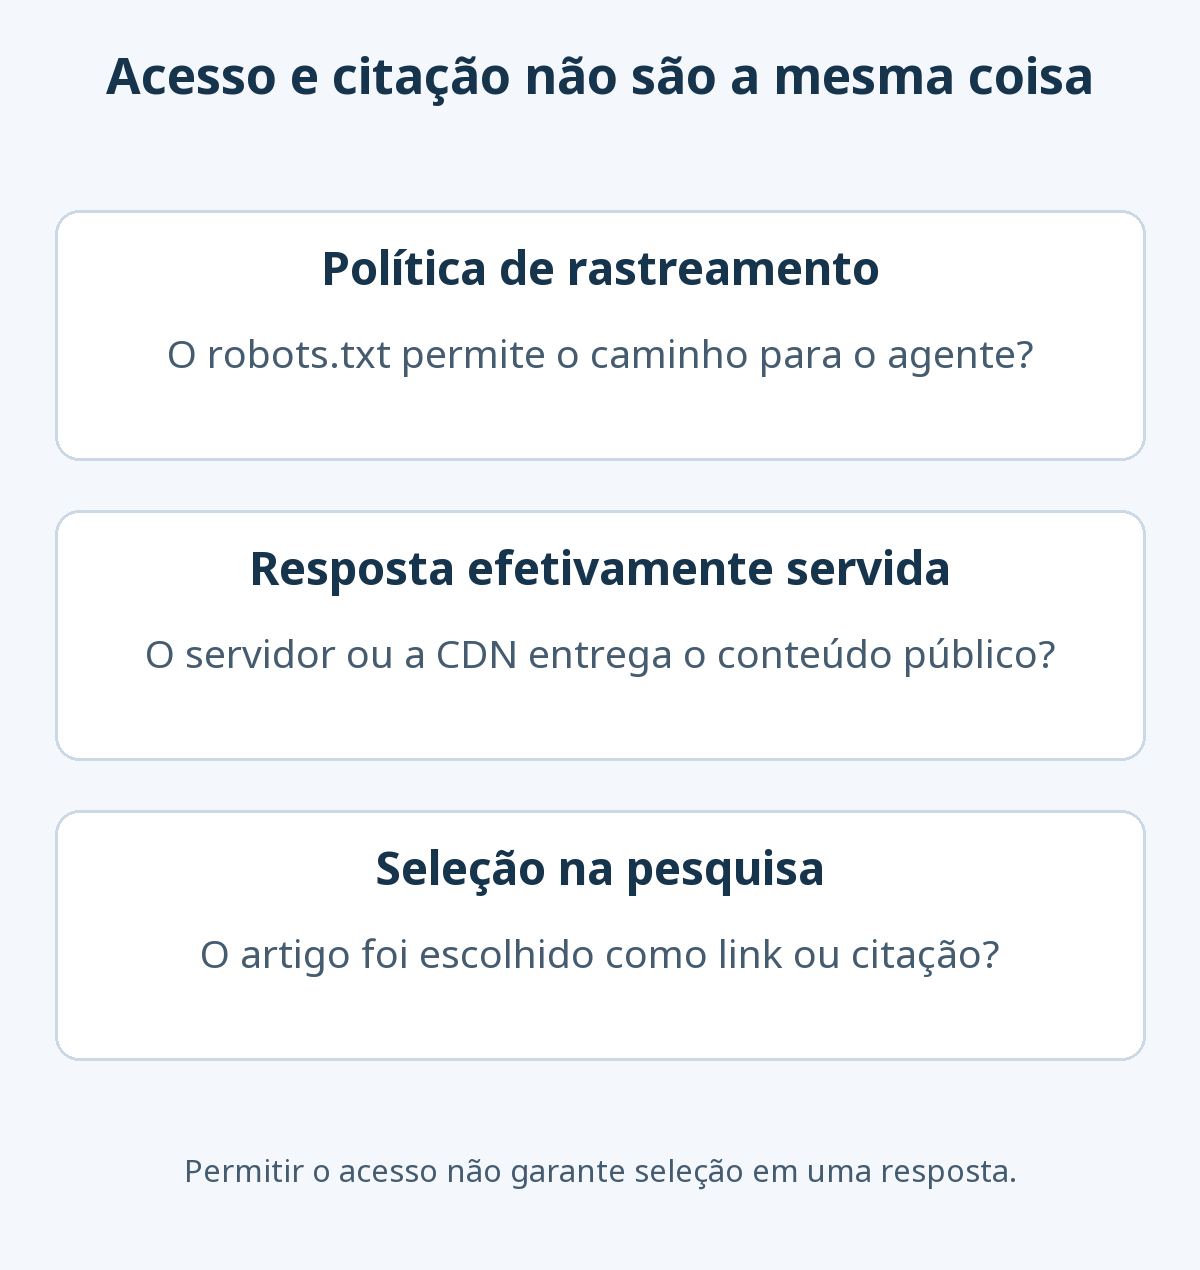
Uma regra de rastreamento e a aceitação efetiva de uma requisição são verificações diferentes. Firewall, proteção contra robôs, login obrigatório ou erro de rede podem impedir o recebimento do artigo. Se houver registros de bloqueio, anote URL, horário e regra envolvida.
Uma rede de distribuição de conteúdo (CDN) pode servir arquivos perto dos visitantes e aplicar proteções antes da hospedagem. Um erro 403, uma tela de login ou um desafio registrado nessa camada pode exigir investigação fora do robots.txt.
Evite começar desativando toda a proteção do site. Localize a regra responsável e restrinja qualquer ajuste ao necessário. Trocar apenas o nome User-Agent em uma requisição de teste não demonstra origem OpenAI. Consulte as faixas de IP oficiais do OAI-SearchBot e os mecanismos de verificação do prestador. Use a lista atual em vez de copiar endereços como se fossem permanentes.
Abrir a página no navegador não garante que o rastreador recebe a mesma resposta. O inverso também exige cuidado: uma tentativa automatizada bloqueada não demonstra que todos os visitantes ou rastreadores foram impedidos. Registre exatamente qual requisição foi observada e em quais condições.
O esquema separa os resultados que podem ser documentados durante o diagnóstico. Assim, uma política configurada não é registrada como se fosse uma recuperação comprovada ou uma citação obtida.
Separe o acesso da seleção nas respostas
Depois de examinar o acesso, confira a apresentação do conteúdo: resposta principal pública, título que descreve o artigo e links relevantes a partir de categorias ou outros posts. Permitir pesquisa não faz o endereço aparecer em todas as respostas.
Registre separadamente “robots.txt responde”, “as regras pretendidas são entregues”, “o texto público está acessível” e “o site foi encontrado em uma pesquisa”. O último resultado pode variar conforme a pergunta e o momento. Uma busca isolada não permite concluir se toda a configuração está correta.
A ajuda da busca do ChatGPT informa os requisitos de elegibilidade e a ausência de posicionamento garantido. Para comprovar uma recuperação efetiva, use registros confiáveis do servidor ou da CDN. A comparação entre SEO, AEO e GEO ajuda a trabalhar a utilidade do conteúdo além da configuração técnica.
Para investigar a presença no Google, consulte a verificação da indexação no Search Console. O estado do índice do Google e a visibilidade na busca do ChatGPT precisam ser avaliados separadamente.
Use autenticação para proteger conteúdo privado
Robots.txt é uma declaração pública de política de rastreamento, sem funcionar como autenticação. A introdução do Google ao robots.txt lembra que nem todos os programas respeitam essas instruções. Proteja áreas de membros e informações administrativas com autenticação e permissões adequadas.
Mantenha juntos o arquivo alterado, as configurações relacionadas e a resposta pública observada para saber o que restaurar. Definir primeiro o conteúdo público destinado à pesquisa e as áreas privadas protegidas ajuda a evitar ampliação desnecessária de acesso durante a investigação.