GPT-6 und GPT-5.6: Sechs Modelle nach Aufgaben und API-Kosten vergleichen
Der Hauptunterschied zwischen GPT-6 Astra, Sol und Luna und GPT-5.6 Sol, Terra und Luna besteht darin, wo jedes Modell im Spektrum aus Qualität, Effizienz und API-Kosten eingeordnet ist. Beginnen Sie mit GPT-6 Astra für die anspruchsvollsten Aufgaben mit offenem Lösungsweg, bewerten Sie GPT-6 Sol, wenn Sie ein Gleichgewicht zwischen Leistungsfähigkeit und Kosten benötigen, und testen Sie GPT-6 Luna für klar eingegrenzte Aufgaben mit hohem Volumen.
Innerhalb der GPT-5.6-Familie ist Sol das Flaggschiff, Terra gleicht Intelligenz und Kosten aus und Luna zielt auf kostensensible Workloads ab. Der gemeinsame Name Sol bedeutet nicht, dass GPT-6 Sol und GPT-5.6 Sol die gleiche Position innerhalb ihrer jeweiligen Familien einnehmen.
Geltungsbereich: API-Modelle und Abonnements unterscheiden
Dieser Vergleich umfasst gpt-6-astra, gpt-6-sol, gpt-6-luna und die drei GPT-5.6-Modelle. Eine Application Programming Interface (API) ermöglicht es der Software, das Modell aufzurufen. Diese Tokenpreise gelten getrennt von ChatGPT- und Codex-Abonnements. Modellzugriff, Reasoning-Einstellungen und Nutzungslimits dieser Produkte können sich ebenfalls unterscheiden.
GPT-6.1 Sol ist im Oktober 2026 bereits verfügbar, daher sollte GPT-6 Sol nicht als neuestes Sol-Modell gelesen werden. Dieser Artikel behält seinen Sechs-Modell-Vergleich für Leser bei, die diese Modelle oder eine bestehende Bereitstellung bewerten. Siehe den Artikel GPT-6.1 Sol (englisch) und aktuellen offiziellen Modellleitfaden für den Nachfolger separat.
Die dokumentierten Rollen sind Ausgangspunkte, nicht ein gemessenes Ranking für jeden Workload. Der offizielle Auswahlleitfaden empfiehlt den Vergleich der gleichen Eingaben über Modelle und Reasoning-Einstellungen hinweg. Neuere Empfehlungen in diesem Leitfaden sollten nicht automatisch dem älteren GPT-6 Sol-Modell zugeschrieben werden.
Sechs Modelle auf einen Blick
| Modell | Stellung in der Familie | Geeignete erste Einsatzgebiete | Inputpreis | Ausgabepreis |
|---|---|---|---|---|
| GPT-6 Astra | Höchste Leistungsfähigkeit | Komplexe Argumentation, Forschung, Codierung, Computernutzung und anspruchsvolle Ergebnisse | $10.00 | $50.00 |
| GPT-6 Sol | Verhältnis von Leistung und Kosten | Alltägliches Codieren, Recherchieren, Schreiben und Workflows mit Tools | $2.00 | $10.00 |
| GPT-6 Luna | Effizientestes GPT-6-Modell | Klassifikation, Extraktion, einfache Transformationen und Automatisierung mit hohem Volumen | $0.10 | $0.50 |
| GPT-5.6 Sol | GPT-5.6 Flaggschiff | Komplexe professionelle Arbeit, Codierung, Front-End-Entwicklung und Tools | $4.00 | $20.00 |
| GPT-5.6 Terra | Intelligenz und Kostenbilanz | Mäßig komplexe Analyse, Dokumentenverarbeitung und Automatisierung | $2.00 | $12.00 |
| GPT-5.6 Luna | Kostensensibles Modell GPT-5.6 | Einfache Extraktion, Klassifizierung, Zusammenfassungen und wiederholbare Workflows | $0.20 | $1.20 |
Die Tabelle spiegelt die sechs offiziellen Modellseiten wider, die am 22. Oktober 2026 überprüft wurden. Die Preise verstehen sich in US-Dollar pro einer Million Texttoken unter Standardverarbeitung für kurze Eingabeaufforderungen, ohne Werkzeuggebühren. Zwischengespeicherte Eingaben, lange Kontextanforderungen, Batch, Flex und schnelle Verarbeitung können unterschiedliche Raten verwenden. Überprüfen Sie die aktuelle OpenAI-Preisseite, bevor Sie eine Workload bereitstellen.
Wie verhalten sich Astra, Sol, Terra und Luna?
Die GPT-6-Familie besteht aus Astra, Sol und Luna. Astra zielt auf die anspruchsvollste Arbeit ab, Sol gleicht Leistungsfähigkeit und Kosten aus und Luna betont Effizienz. GPT-5.6 verwendet Sol, Terra und Luna für sein Flaggschiff, ausgewogene und effiziente Tiers. OpenAI beschreibt GPT-5.6 Terra als ungefähr einer früheren Mini-Ebene und GPT-5.6 Luna als einer früheren Nano-Ebene. Der API-Alias gpt-5.6 verweist auf GPT-5.6 Sol.
| Rolle innerhalb der Familie | GPT-6 | GPT-5.6 |
|---|---|---|
| Höchste Leistungsfähigkeit | Astra | Sol |
| Ausgewogene Leistungsstufe | Sol | Terra |
| Effizienzstufe | Luna | Luna |
Diese Tabelle beschreibt Rollen innerhalb jeder Familie. Es wird nicht behauptet, dass Modelle in derselben Zeile über Generationen hinweg die gleiche Qualität, Geschwindigkeit oder Ausstattung haben. Insbesondere ist GPT-6 Sol die ausgewogene GPT-6-Option, während GPT-5.6 Sol das Flaggschiff GPT-5.6 ist.
GPT-6 Astra: für die härteste End-to-End-Arbeit
Die Modell-ID lautet gpt-6-astra. OpenAI präsentiert Astra als sein fähigstes Modell für komplexes Denken, Software-Engineering, Computernutzung, Forschung und Dokumentenerstellung. Es ist der stärkste Startkandidat, wenn eine Aufgabe mehrere Schritte in Dateien, Tools und unsicheren Anforderungen erfordert.
- Projekte mit unvollständigen Anforderungen, die ein sorgfältiges Urteil erfordern
- Lange Codier-Workflows, die Design, Implementierung und Verifizierung umfassen
- Forschung, die widersprüchliche Quellen in Einklang bringen und Unsicherheit erklären muss
- Komplexe Arbeit mit Dokumenten, Daten, Browsern und professioneller Software
Astra hat in diesem Vergleich die höchsten gelisteten Token-Preise. Dennoch berichtet der GPT-6-Modellleitfaden, dass er in einigen Auswertungen stärkere Ergebnisse mit weniger Output-Tokens als frühere Modelle lieferte. Diese Beobachtung legt nicht die Kosten für Ihre Arbeitsbelastung fest: Vergleichen Sie die Gesamtkosten pro akzeptiertem Ergebnis, einschließlich Wiederholungen und Überprüfungen.
GPT-6 Sol: ein Gleichgewicht zwischen Leistungsfähigkeit und Kosten
Die Modell-ID lautet gpt-6-sol. Es ist für komplexe Codierung und agentische Workflows zu einem niedrigeren gelisteten Token-Preis als Astra konzipiert. Sol ist es wert, getestet zu werden, wenn das Ziel klar ist, aber die Arbeit immer noch Urteilsvermögen, Werkzeuggebrauch und ein poliertes Ergebnis erfordert.
- Routine-Feature-Entwicklung, Debugging, Code-Review und Tests
- Schreiben, das Recherche und Quellenprüfungen erfordert
- Workflows über Tabellenkalkulationen, Dokumente, Browser und Dateien
- Mehrstufige Aufgaben, deren Mehrdeutigkeit das höchstmögliche Modell nicht rechtfertigt
Innerhalb dieser sechs Modelle kann Sol eine praktische Basislinie sein, wenn es um Kosten geht. Vergleichen Sie Astra, wenn es wichtige Anforderungen verfehlt, und Luna, wenn eine klar eingegrenzte Aufgabe zu geringeren Kosten bestanden wird. Dies ist eine Bewertungsstrategie für den Vergleich, keine Behauptung, dass GPT-6 Sol der aktuelle Standard in jedem Produkt ist. Aktuelle offizielle Codierungsdokumentation diskutiert auch GPT-6.1 Sol als neueres Allzweckmodell.
GPT-6 Luna: effizientes Arbeiten an klar eingegrenzten Aufgaben in großem Maßstab
Die Modell-ID lautet gpt-6-luna. OpenAI beschreibt es als das effizienteste GPT-6-Modell für fokussierte, hochvolumige Aufgaben. Es hat die niedrigsten Input- und Output-Token-Preise unter den sechs Modellen in diesem Artikel.
- Extrahieren und Klassifizieren von Informationen in ein definiertes Format
- Kurze Zusammenfassungen, Stiländerungen und Metadatengenerierung
- Beschränkte Dateibearbeitungen und Datenbereinigung
- Erstellung von Entwürfen in großem Maßstab für die menschliche Überprüfung
Für mehrdeutige oder wirkungsvolle Arbeit können Retries und menschliche Korrekturen einen niedrigen Token-Preis überwiegen. Geben Sie Luna enge Anweisungen, geben Sie das Ausgabeformat an und überprüfen Sie eine Stichprobe der Ergebnisse mit einem klaren Qualitätsstandard.
GPT-5.6 Sol: das Flaggschiff GPT-5.6
Die Modell-ID ist gpt-5.6-sol, und der gpt-5.6-Alias führt zu ihr. Seine offizielle Modellseite identifiziert es als das GPT-5.6 Flaggschiff für komplexe professionelle Arbeit.
Vergleichen Sie für eine neue Anwendung die GPT-6-Modelle, bevor Sie sich für GPT-5.6 Sol entscheiden. Eine bestehende Anwendung kann jedoch Eingabeaufforderungen, Auswertungen und Betriebsziele haben, die auf GPT-5.6 Sol kalibriert sind. Vergleichen Sie identische Aufgaben hinsichtlich Qualität, Latenz, Token-Nutzung und Fehlerrate, bevor Sie einen Produktionsworkflow ändern.
Kompatibilität ist eine Bewertungsfrage, kein Grund, ein älteres Modell auf unbestimmte Zeit beizubehalten. Testen Sie vorhandene Eingabeaufforderungen, Ausgabeschemata und Tool-Workflows auf Regressionen. Wenn ein neueres oder weniger teures Modell die gleichen Akzeptanzkriterien erfüllt, kann es die Betriebskosten senken; bewahren Sie die alte Konfiguration bei, während Sie diesen Übergang überprüfen.
GPT-5.6 Terra: eine mittlere Ebene für GPT-5.6-Aufgaben
Die Modell-ID lautet gpt-5.6-terra. Die offizielle Terra-Seite positioniert sie als ein Gleichgewicht von Intelligenz und Kosten, das in etwa einer früheren GPT-5 Mini-Ebene entspricht.
Terra eignet sich für Dokumentenverarbeitung, Inhaltsgenerierung, -analyse und -automatisierung, die mehr Urteilsvermögen erfordern als eine einfache Extraktionsaufgabe. Bei den aufgeführten Standardpreisen hat es jedoch den gleichen Inputpreis wie GPT-6 Sol und einen höheren Outputpreis. Bestehende Systemkompatibilität, Reaktionsqualität und Latenz sollten getestet werden, bevor Terra allein zum Preis gewählt wird.
GPT-5.6 Luna: Kostensensible 5.6 Workflows
Die Modell-ID lautet gpt-5.6-luna. Die offizielle Luna-Seite beschreibt ein Modell für kostensensible, hochvolumige Arbeiten, die in etwa einer früheren Nano-Ebene entsprechen.
Es ist ein Kandidat für Klassifizierung, Extraktion und kurze Zusammenfassungen mit klaren Output-Kriterien. Bei den Short-Prompt-Standardpreisen in der Tabelle sind die von GPT-6 Luna aufgeführten Standard-Input- und Output-Tokenpreise niedriger als die von GPT-5.6 Luna. Bewerten Sie GPT-6 Luna zuerst für eine neue Workload, während GPT-5.6 Luna als Vergleich beibehalten wird, wenn die Kompatibilität mit einem bestehenden 5.6-System von Bedeutung ist.
Gemeinsame Spezifikationen und sinnvolle Unterschiede
| Spezifikation | GPT-6-Familie | GPT-5.6-Familie |
|---|---|---|
| Kontextfenster | 1.050.000 Token | 1.050.000 Token |
| Eingabe bei reservierter maximaler Ausgabe | 922.000 Token | 922.000 Token |
| Maximale Ausgabe | 128.000 Token | 128.000 Token |
| Bildmodalität | Bildeingabe; Textausgabe | Bildeingabe; Textausgabe |
| Reasoning-Aufwand | Astra: low bis maxSol und Luna: none bis max |
Sol, Terra und Luna: none bis max |
| Wissensstand | Astra: 30. April 2026 Sol: 20. April 2026 Luna: 18. Mai 2026 |
Alle drei: 16. Februar 2026 |
Ein Kontextfenster mit 1.050.000 Token bedeutet nicht, dass Sie so viele Eingangstoken senden können. Wer 128.000 Token für die maximale Ausgabe reserviert, hat rechnerisch noch 922.000 Token im Kontextfenster frei. Generierte Ausgabe und Reasoning benötigen ebenfalls Platz; beachten Sie zusätzlich die tatsächlichen API-Grenzen. Ein späterer Wissensstand bedeutet nicht, dass ein Modell bei jeder Frage besser abschneidet. Schließen Sie für aktuelle Ereignisse oder sich ändernde Fakten eine aktuelle Quelle an und überprüfen Sie die Antwort. Das Kontextfenster ist auch eine maximal unterstützte Kapazität, keine Empfehlung, sehr lange Aufforderungen zu senden: Long Input kann unterschiedliche Preise verwenden.
Wie wählen Sie den Reasoning-Aufwand?
Der Reasoning-Aufwand steuert, wie viel Berechnung ein Modell verwenden kann, um ein Problem zu bearbeiten, bevor eine Antwort erstellt wird. Eine höhere Einstellung kann Latenz und Kosten bei einfachen Aufgaben erhöhen, ohne einen nützlichen Qualitätsgewinn zu bringen. GPT-6 Astra unterstützt none nicht; die anderen fünf hier aufgeführten Modelle tun dies.
| Reasoning-Aufwand | Nützliche Startaufgaben | Was zu überprüfen ist |
|---|---|---|
none oder low |
Klassifikation, Extraktion, kleine Bearbeitungen und latenzsensitive Arbeit | Astra unterstützt none nicht. |
medium |
Tägliches Programmieren, Schreiben, Recherchieren und Werkzeuggebrauch | Eine praktische Basis für Vergleiche |
high oder xhigh |
Schwierige Analyse, erweiterte Aufgaben, Verifizierung und Debugging | Messen Sie, ob sich die Qualität verbessert |
max |
Die schwierigsten Aufgaben, bei denen Qualität dominiert | Latenz und Kosten können erheblich steigen |
Die Auswahlrichtlinie von OpenAI empfiehlt, repräsentative Eingaben zu testen und die leichteste Modell- und Argumentationseinstellung beizubehalten, die Ihrer Qualitätsanforderung entspricht. Notieren Sie den Reasoning-Aufwand neben dem Modellnamen beim Vergleich der Ergebnisse.
Die "High"-Einstellung einer App und ein API-Aufwandswert sind keine austauschbaren Spezifikationen. Überprüfen Sie das genaue Modell und die Schnittstelle. Zum Beispiel unterstützt der ältere GPT-6 Sol none, während Astra und der neuere GPT-6.1 Sol dies nicht tun.
Wie schätzen Sie die API Kosten ein?
Für nicht zwischengespeicherten Text unter Standard-Short-Prompt-Preisen, vor Werkzeuggebühren und regionalen Prämien, verwenden Sie die folgende Schätzung. Tokens sind modellverarbeitende Einheiten; sie ordnen Zeichen oder Wörtern nicht eins zu eins zu.
Geschätzte Kosten = Input-Tokens ÷ 1.000.000 × Input-Rate + Output-Token ÷ 1.000.000 × Output-Rate.
Für einen gemeinsamen Vergleich zwischen den Spracheditionen nehmen Sie 100 Anfragen an, die jeweils 10.000 Eingangstoken und 2.000 abrechenbare Ausgangstoken verwenden. Die Summe besteht aus einer Million Input- und 200.000 Output-Token, nicht einer übergroßen Anfrage. Jede Anforderung befindet sich in der Short-Prompt-Ebene, ohne Caching, Tool-Charge oder Retries. Diese Zählungen sind illustrative Annahmen, nicht beobachtete Nutzung.
| Modell | Input + Output | Veranschaulichende Kosten |
|---|---|---|
| GPT-6 Astra | US$ 10.00 + 10.00 | US$ 20.00 |
| GPT-6 Sol | US$ 2,00 + 2,00 | US$ 4,00 |
| GPT-6 Luna | US$ 0.10 + 0.10 | US$ 0,20 |
| GPT-5.6 Sol | US$ 4.00 + 4.00 | US$ 8.00 |
| GPT-5.6 Terra | US$ 2,00 + 2,40 | US$ 4,40 |
| GPT-5.6 Luna | US$ 0,20 + 0,24 | US$ 0,44 |
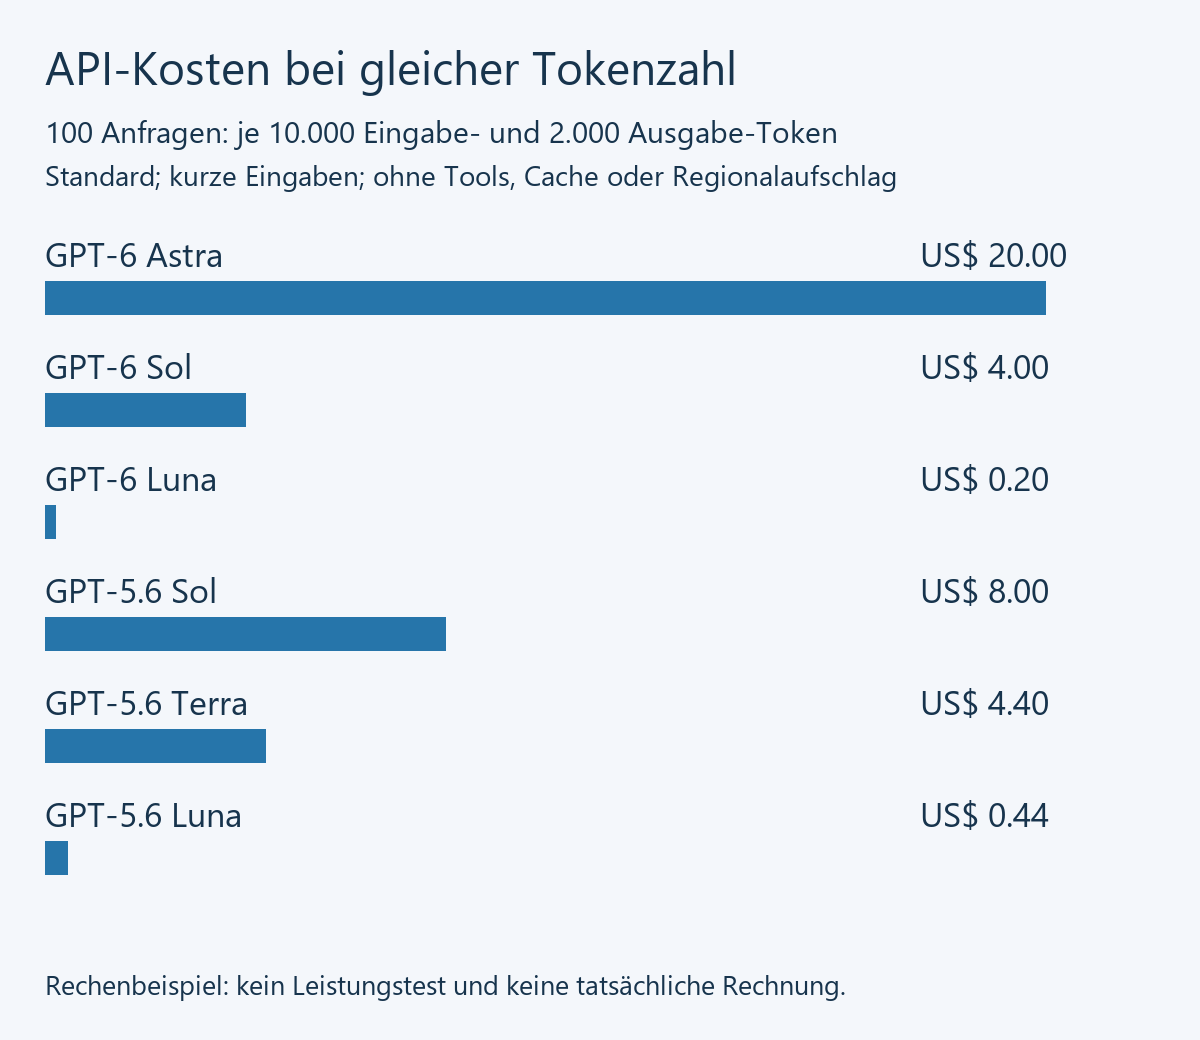
Das Beispiel hält Tokenzahlen konstant; es ist kein Qualitäts-Benchmark oder eine tatsächliche Rechnung. Mehr Argumentation, Tool-Nutzung oder Retries können den Verbrauch verändern. Die offizielle Reasoning-Dokumentation erklärt, dass unsichtbare Reasoning-Token als Output-Token abgerechnet werden. Sie sind in der Antwort usage.output_tokens enthalten; Ein zusätzliches Addieren der Reasoning-Token würde diese doppelt zählen.
Längere Eingabeaufforderungen ändern die anwendbaren Sätze. Jede dieser sechs Modellseiten gibt an, dass Eingabeaufforderungen, die 272.000 Eingabetoken überschreiten, die doppelte Eingaberate und das 1,5-fache der Ausgaberate für die vollständige Anforderung verwenden. Für GPT-6 Sol kostet eine hypothetische Einzelanforderung mit 300.000 Input- und 2.000 Output-Tokens daher 0,3 × US$4 + 0,002 × US$15 = US$1,23, vor dem Caching oder Tools, anstatt US$0,62 zu den Short-Prompt-Raten.
Cache-Lese- und Schreibzugriffe, Batch, Flex, Fast, regionale Verarbeitung, Tools und Retries können auch die Gesamtmenge ändern. Die Werbepreise von GPT-5.6 Sol sind mindestens bis zum 21. November 2026 als verfügbar dokumentiert, gehen Sie also nicht davon aus, dass sie dauerhaft sind. Wählen Sie die entsprechende Verarbeitungsebene auf der offiziellen Preisseite bei der Budgetierung aus.
Welches Modell sollten Sie für Ihren Use Case testen?
| Situation | Erstes Modell zum Testen | Grund |
|---|---|---|
| Harte Forschung, Design oder lang laufende Agentenarbeit | GPT-6 Astra | Für Aufgaben mit unklaren Anforderungen und mehreren Tools ausgelegt |
| Professionelles Schreiben, Codieren und alltägliche Automatisierung mit Kostenbeschränkungen | GPT-6 Sol | Verbindet hohe Leistungsfähigkeit mit niedrigeren aufgeführten Tokenkosten |
| Großskalige Extraktion, Klassifizierung oder einfache Transformationen | GPT-6 Luna | Niedrigste aufgeführte Standard-Token-Preise hier |
| Aufrechterhaltung eines GPT-5.6 Flaggschiff-Workflows | GPT-5.6 Sol | Bewahrt eine etablierte Bewertungsgrundlage auf |
| Beibehaltung einer mittleren Ebene innerhalb von GPT-5.6 | GPT-5.6 Terra | Ausgewogene Option in der GPT-5.6-Familie |
| Aufrechterhaltung einer kostengünstigen, hochvolumigen GPT-5.6-Verarbeitung | GPT-5.6 Luna | Behält vorhandenes GPT-5.6-Verhalten im Vergleich bei |
Dies sind Kandidaten für die Bewertung, nicht gemessene Performance-Rankings. Die beste Wahl hängt von Ihren tatsächlichen Eingaben, Akzeptanzkriterien, Latenzziel und vollen Kosten pro abgeschlossener Aufgabe ab.
Eine praktische Möglichkeit, die Modelle zu vergleichen
Veröffentlichte Spezifikationen erklären die beabsichtigte Rolle jedes Modells, aber ein einzelner generischer Benchmark kann kein Modell für jeden Produktionsworkflow auswählen. Verwenden Sie einen kleinen, repräsentativen Bewertungssatz:
- Repräsentative Aufgaben sammeln. Normalfälle, fehlende Informationen, widersprüchliche Einschränkungen, lange Eingaben und bekannte Fehler einschließen. Legen Sie die erforderlichen Fakten oder Abnahmeprüfungen fest, bevor Sie die Modellantwort sehen.
- Steuern Sie die anderen Bedingungen. Verwenden Sie die gleichen Anweisungen, Quellen, Tools und Ausgabeformat. Beginnen Sie mit einer gemeinsam unterstützten Reasoning-Einstellung und testen Sie dann die leichteren Einstellungen einzeln. Zwingen Sie ein Modell nicht, einen Wert zu verwenden, den es nicht unterstützt.
- Qualität und Gesamtkosten erfassen. Überprüfen Sie Richtigkeit, Auslassungen, Format und Tool-Erfolg neben Latenz, Token-Nutzung jeder Anfrage, Wiederholungen und menschlicher Korrekturzeit. Beschränken Sie Berechtigungen, wenn eine Auswertung auf Folgesysteme oder Daten zugreifen kann.
- Aufgabenspezifische Bestehenskriterien anwenden. Überprüfen Sie zum Extrahieren fehlende Felder und nicht unterstützte Werte. Überprüfen Sie bei Codeänderungen die Anforderungen und das bestehende Verhalten. Eine längere oder flüssigere Ausgabe ist nicht selbst ein besseres Ergebnis.
- Vergleichen Sie die Kosten pro akzeptiertem Ergebnis. Günstige einzelne Anrufe können nach Fehlern und Überprüfung ihren Vorteil verlieren. Ein leichteres Modell für gewöhnliche Fälle, mit Eskalation für unsichere oder gescheiterte, ist eine weitere zu bewertende Konfiguration.
- Änderungen rückgängig machen können. Zeichnen Sie das alte Modell und die Prompt-Konfiguration auf und vergleichen Sie eine begrenzte Anzahl von Aufgaben, bevor Sie wechseln. Stellen Sie die vorherige Einrichtung wieder her, wenn sich die Regressionen erhöhen. Überprüfen Sie erneut repräsentative Fälle, in denen sich Aliase, Preise oder das Verhalten von Werkzeugen ändern.
Dieser Prozess beschreibt eine Bewertung, die in Ihrer Umgebung ausgeführt werden soll. Ein stärkeres Modell oder ein höherer Aufwand können veraltetes oder nicht unterstütztes Quellmaterial nicht zuverlässig machen. Für Recherche und Schreiben, halten Sie fact-checking KI-Informationen (englisch) neben der Modellauswahl.