Rendre un blog accessible aux robots de recherche ChatGPT
Pour qu’un blog puisse être découvert dans la recherche ChatGPT, vérifiez d’abord l’accès d’OAI-SearchBot, le robot de recherche OpenAI. Son rôle diffère de celui de GPTBot, utilisé pour la collecte destinée à l’entraînement : les deux politiques peuvent être définies séparément. Autoriser un robot ne garantit pas l’affichage ou la citation de votre site dans une réponse donnée.
Distinguer les robots de recherche et d’entraînement
Un robot d’exploration récupère automatiquement des pages Web. OpenAI emploie plusieurs identifiants user-agent selon l’usage. Ce champ permet au programme de se présenter au serveur ; le responsable du site peut définir une politique pour chaque nom.
| Nom | Rôle principal | Politique concernée |
|---|---|---|
| OAI-SearchBot | Collecte automatique pour les résultats de recherche ChatGPT. | Accès à la recherche. |
| GPTBot | Collecte de contenus pouvant servir à entraîner les modèles fondamentaux. | Autorisation de collecte pour l’entraînement. |
| ChatGPT-User | Visites déclenchées par une demande utilisateur. | Comportement distinct d’un robot automatique de recherche. |
La documentation officielle des robots OpenAI décrit l’indépendance des réglages de recherche et d’entraînement. Elle indique aussi que robots.txt peut ne pas s’appliquer aux visites initiées par les utilisateurs. Bloquer GPTBot seul ne contrôle donc pas tous les accès liés à ChatGPT.
Elle distingue réponses de recherche et liens de navigation : un site refusant OAI-SearchBot ne figure pas dans les réponses de recherche, mais peut encore apparaître comme lien de navigation. Voir un lien ne prouve donc pas la récupération du texte. Les visites ChatGPT-User ne déterminent pas non plus l’éligibilité à Search.
Relever les réglages publics actuels
Décidez d’abord de la politique : recherche autorisée, collecte d’entraînement autorisée ou non, et emplacement des contenus privés. Conservez robots.txt et les réglages de sécurité concernés pour pouvoir les restaurer.
- Sans connexion, ouvrez l’article que vous souhaitez rendre découvrable.
- Consultez
/robots.txtsur le protocole et l’hôte publics réels.https://example.com/robots.txtethttps://www.example.com/robots.txtn’ont pas le même périmètre. - Examinez les groupes OAI-SearchBot et GPTBot, ainsi que le groupe par défaut
User-agent: *utilisé sans groupe correspondant. - Recherchez aussi les blocages dans l’hébergement, les extensions de sécurité ou le réseau de diffusion de contenu.
WordPress peut servir un fichier physique, une réponse produite par une extension ou un fichier généré dynamiquement. Vérifiez que les modifications d’administration arrivent réellement dans la réponse publique. Identifiez le composant responsable au lieu de supposer qu’une extension précise est installée.
Lire un exemple autorisant la recherche et refusant l’entraînement
Cet exemple autorise la recherche sur le contenu public et interdit la collecte GPTBot. Il ne remplace pas intégralement le fichier de chaque site. Conservez déclarations de sitemap et restrictions utiles, puis fusionnez les règles selon votre politique.
User-agent: OAI-SearchBot
Allow: /
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-agent: GPTBot
Disallow: /
Le groupe OAI-SearchBot inclut ici la restriction WordPress courante /wp-admin/ et l’exception admin-ajax.php. Vérifiez leur pertinence pour votre site. Une interdiction plus précise peut s’appliquer malgré Allow: /. Le Disallow: / de GPTBot exprime le refus sur l’ensemble des chemins. Ajoutez séparément les autres exclusions nécessaires, comme les espaces réservés aux membres.
Ne supposez pas qu’un groupe dédié hérite des restrictions de User-agent: *. Les règles de sélection de groupe de la norme robots.txt, RFC 9309 utilisent le groupe par défaut lorsqu’aucun groupe d’agent ne correspond. Reprenez dans le groupe dédié les restrictions encore nécessaires. Les contenus privés demandent dans tous les cas authentification et autorisations.
Voici l’interprétation de l’exemple, sans prétendre observer des requêtes réelles d’OpenAI :
- OAI-SearchBot sur un article public : autorisé sauf restriction plus précise.
- OAI-SearchBot sous
/wp-admin/: interdit par cette règle. - OAI-SearchBot sur
/wp-admin/admin-ajax.php: l’exception plus précise s’applique. - GPTBot sur les articles : collecte d’entraînement refusée par la politique.
RFC 9309 combine les règles des groupes correspondant au même agent puis retient le chemin correspondant le plus précis. Ce n’est pas une règle où « la dernière ligne gagne toujours ».
Recherchez un groupe existant pour le même agent et résolvez doublons et contradictions avant d’enregistrer. Ensuite, vérifiez les caches et rouvrez le /robots.txt public. Si la réponse diffère de l’intention, restaurez fichier et paramètres initiaux et examinez leur gestion.
OpenAI indique environ 24 heures pour l’ajustement de ses systèmes à une modification de robots.txt. Ce délai concerne les règles d’accès, sans promettre découverte ou citation en 24 heures.
Un accès autorisé dans robots.txt peut encore échouer
La politique du fichier et l’acceptation réelle d’une requête sont deux points distincts. Pare-feu, protection anti-robots, connexion obligatoire ou erreur réseau peuvent empêcher la récupération. Si les outils fournissent des journaux de blocage, relevez URL, heure et règle concernée.
Un réseau de diffusion de contenu (CDN) sert des ressources près des visiteurs et peut aussi appliquer des protections avant l’hébergement. Une réponse 403, une page de connexion ou un défi dans ses journaux demande donc parfois une investigation au-delà de robots.txt.
Ne commencez pas par désactiver toute la protection anti-robots. Identifiez la règle responsable et limitez l’ajustement au besoin. Changer le nom user-agent d’une requête de test ne prouve pas son origine OpenAI : comparez aussi les plages IP officielles d’OAI-SearchBot aux mécanismes de vérification du prestataire. Utilisez la liste actuelle plutôt que des exemples d’adresses supposés permanents.
Une page ouverte dans votre navigateur ne garantit pas la même réponse au robot. Inversement, un seul essai automatisé bloqué ne démontre pas le blocage de tous les lecteurs ou robots. Notez quelle requête a été testée et sous quelles conditions.
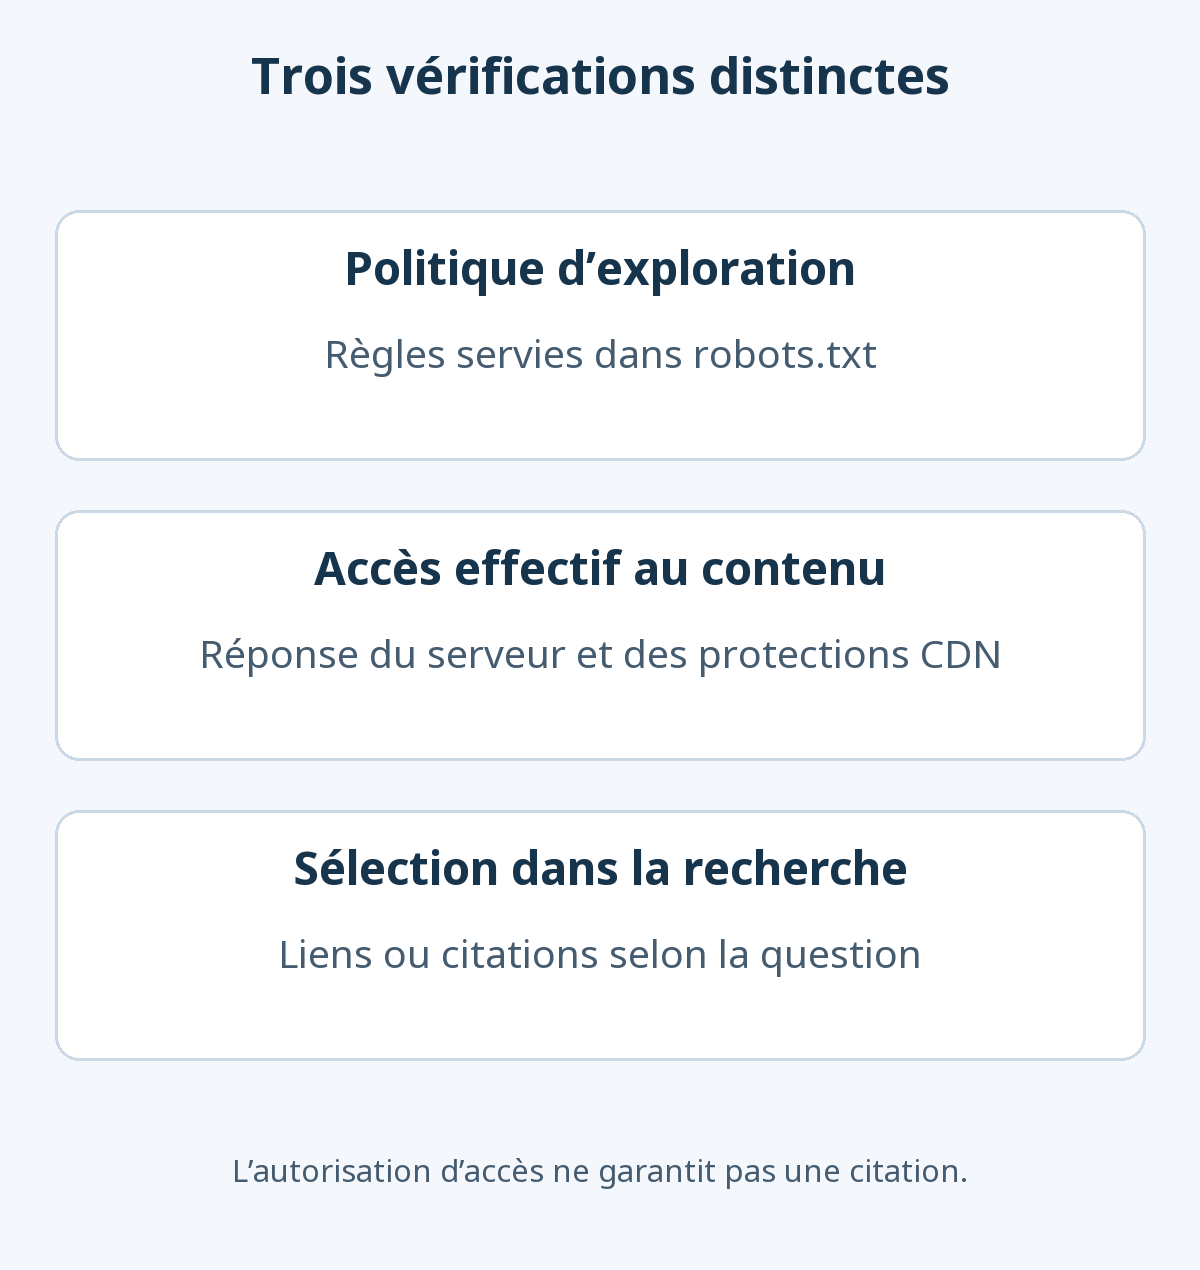
Politique d’exploration, réponse servie et sélection dans la recherche sont des vérifications différentes. Le schéma aide à consigner ce qui est établi et ce qui reste incertain.
Séparer configuration d’accès et visibilité dans les réponses
Après l’accès, examinez contenu et liens : réponse principale publique, accès depuis articles ou catégories pertinents, titre fidèle au texte. L’autorisation de recherche n’est pas un interrupteur faisant apparaître votre lien dans chaque réponse.
Consignez séparément « robots.txt répond », « les règles voulues sont servies », « le texte public est accessible » et « le site a été trouvé dans une recherche ». Ce dernier constat varie selon question et moment ; une seule recherche ne tranche pas fiablement la réussite de la configuration.
L’aide de la recherche ChatGPT décrit aussi l’éligibilité et l’absence de placement garanti. Il faut des journaux serveur ou CDN fiables pour établir une récupération réelle. Pour le contenu, les rôles du SEO, de l’AEO et du GEO aident à structurer une réponse utile. Distinguez l’accès de l’intérêt de citer l’article.
Pour Google, consultez la vérification de l’indexation dans Search Console. L’état de l’index Google et la visibilité ChatGPT ne se remplacent pas.
Robots.txt n’est pas une frontière de sécurité
Robots.txt est une déclaration publique de politique, pas un mécanisme d’authentification. La présentation Google de robots.txt rappelle que tous les robots ne suivent pas ses règles. Protégez contenus membres et informations d’administration avec authentification et permissions.
Conservez ensemble fichier modifié, règles de sécurité et réponse publique pour savoir quoi rétablir. Définir d’abord périmètre public de recherche et périmètre privé protégé réduit le risque d’élargir inutilement l’accès pendant le diagnostic.