Un blog a-t-il besoin de llms.txt ? Rôle du fichier et visibilité
Un blog généraliste n’a pas besoin d’un fichier llms.txt pour apparaître dans la recherche Google ou ses fonctionnalités de recherche par IA générative. Google indique ne pas utiliser ce fichier pour cette visibilité. Si vous souhaitez fournir des informations à un agent IA ou à un outil documentaire précis, évaluez séparément sa prise en charge réelle du format.
Qu’est-ce que llms.txt ?
Llms.txt est une proposition destinée à fournir des informations de contexte et des liens documentaires pour aider un grand modèle de langage, ou LLM pour Large Language Model, ou un agent à utiliser un site. Le fichier emploie Markdown ; malgré son extension .txt, il ne s’agit pas simplement d’une liste de mots-clés.
La proposition llms.txt v2, mise à jour en août 2026, prévoit un fichier à la racine du site ou dans un sous-chemin pour orienter les outils vers la documentation pertinente. Mettre ce fichier à disposition ne démontre pas que tous les services d’IA le lisent ou l’utilisent pour classer leurs résultats de recherche.
Comme exemple réel de publication, l’index de la documentation développeur OpenAI donne accès à des ensembles documentaires et à des tâches courantes. Un fournisseur qui publie un guide de navigation et un moteur qui utilise ce fichier pour évaluer des pages constituent deux affirmations différentes, qui demandent chacune une preuve.
Pour un blog, définissez d’abord le but. « Fournir à un agent précis le contexte et les chemins de référence de notre documentation » aide davantage à décider que « être plus visible auprès de l’IA ».
Est-il nécessaire pour être visible dans Google ?
Le guide Google des fonctionnalités de recherche par IA générative précise que llms.txt, les fichiers textuels spécifiques à l’IA et les balisages spéciaux ne sont pas nécessaires et ne sont pas utilisés par la recherche Google. Leur ajout ne permet donc pas de promettre une amélioration de la visibilité ou du classement.
Cette explication concerne la recherche Google. Ne la transformez pas en affirmation selon laquelle aucun outil d’une autre entreprise ni aucun agent personnalisé n’utilise le fichier. À l’inverse, sa présence dans certaines documentations développeur ne le rend pas obligatoire pour tous les blogs.
Si quelqu’un recommande de l’installer, demandez quel service confirme son utilisation et de quelle manière. Un outil de diagnostic qui attribue des points pour la présence d’un fichier n’exprime pas nécessairement les exigences d’un moteur réel. Identifiez le problème à résoudre plutôt que de chercher seulement à augmenter une note.
Quelles différences avec robots.txt et un sitemap ?
| Fichier | Rôle principal | À ne pas confondre avec |
|---|---|---|
| robots.txt | Communiquer aux robots des règles d’accès aux URL | L’authentification ou la protection de contenus privés |
| Sitemap | Fournir aux moteurs des URL du site et des informations associées | Une garantie d’indexation ou de classement |
| llms.txt | Donner contexte et chemins documentaires aux agents compatibles | Un remplacement des règles d’accès à la recherche ou de refus d’entraînement |
Consultez la présentation du contrôle d’exploration par robots.txt et la présentation officielle des sitemaps. Des fichiers textuels qui se ressemblent ne remplissent pas les mêmes fonctions.
Écrire llms.txt ne résout pas un blocage d’accès au site. Vérifiez d’abord que les articles publics s’ouvrent et examinez les règles des robots. Pour la recherche Google, utilisez les outils correspondants, comme l’inspection d’URL dans Search Console.
Dans quels cas peut-il être utile ?
Envisagez ce fichier si vous exploitez un agent qui consulte votre documentation développeur ou si votre plateforme documentaire le prend en charge pour un usage précis. Vérifiez à la fois la proposition actuelle et les exigences de l’outil qui doit lire le fichier.
- Outil destinataire : identifiez celui qui lit effectivement le fichier.
- Périmètre : déterminez s’il couvre tout le site ou un chemin documentaire particulier.
- Entretien : attribuez la responsabilité de sa mise à jour lorsque les sources ou les URL changent.
- Vérification : distinguez l’accès au fichier, les liens fonctionnels et son utilisation réelle par l’outil.
Pour un blog comportant quelques articles d’information générale, améliorer l’exactitude, les liens internes et l’accès public peut être plus utile en premier. Si les termes SEO, AEO et GEO prêtent à confusion, cette comparaison de l’optimisation pour les moteurs de recherche, les moteurs de réponse et les moteurs génératifs aide à distinguer leurs objectifs avant de choisir une action.
Créer un petit guide qui ne remplace pas les sources
Une fois le but défini, commencez par une courte présentation du site et des liens vers des documents importants qui existent réellement. L’exemple fictif suivant illustre la structure ; remplacez ses adresses et descriptions par celles de votre documentation publique. N’ajoutez pas .md à une URL si aucune version Markdown n’y est réellement servie.
# Documentation d’un blog exemple

> Un guide court pour trouver la documentation sur le fonctionnement du blog.

Seuls des documents publics sont indiqués. Vérifier les conditions applicables dans chaque document original.

## Documents
- [Premiers pas](https://example.com/docs/start.md) : périmètre et utilisation de la documentation
- [Règles de rédaction](https://example.com/docs/writing.md) : préparation et vérification des articles
Le # de la première ligne désigne le titre principal du document Markdown. La section ## Documents regroupe les liens, leurs noms et de courtes descriptions. Cette syntaxe appartient au fichier llms.txt ; elle ne demande pas d’ajouter un autre <h1> dans un article WordPress. Vérifiez le format accepté par l’outil destinataire en plus de la proposition.
L’exemple explique une structure de fichier sans prétendre que ces adresses contiennent les documents annoncés. Dans une installation réelle, vérifiez que le fichier est servi et que chaque lien mène au contenu prévu. Une description qui ne correspond plus à sa source peut devenir un résumé périmé.
Après mise en place, effectuez les contrôles opérationnels suivants. Ils vérifient un guide documentaire ; ils ne mesurent pas un gain de classement dans les résultats de recherche.
- Ouvrez l’adresse exacte hors connexion. Enregistrer du texte dans l’éditeur d’article ne publie pas automatiquement un fichier à ce chemin. Vérifiez le fichier serveur ou la route réelle et la documentation de l’hébergeur.
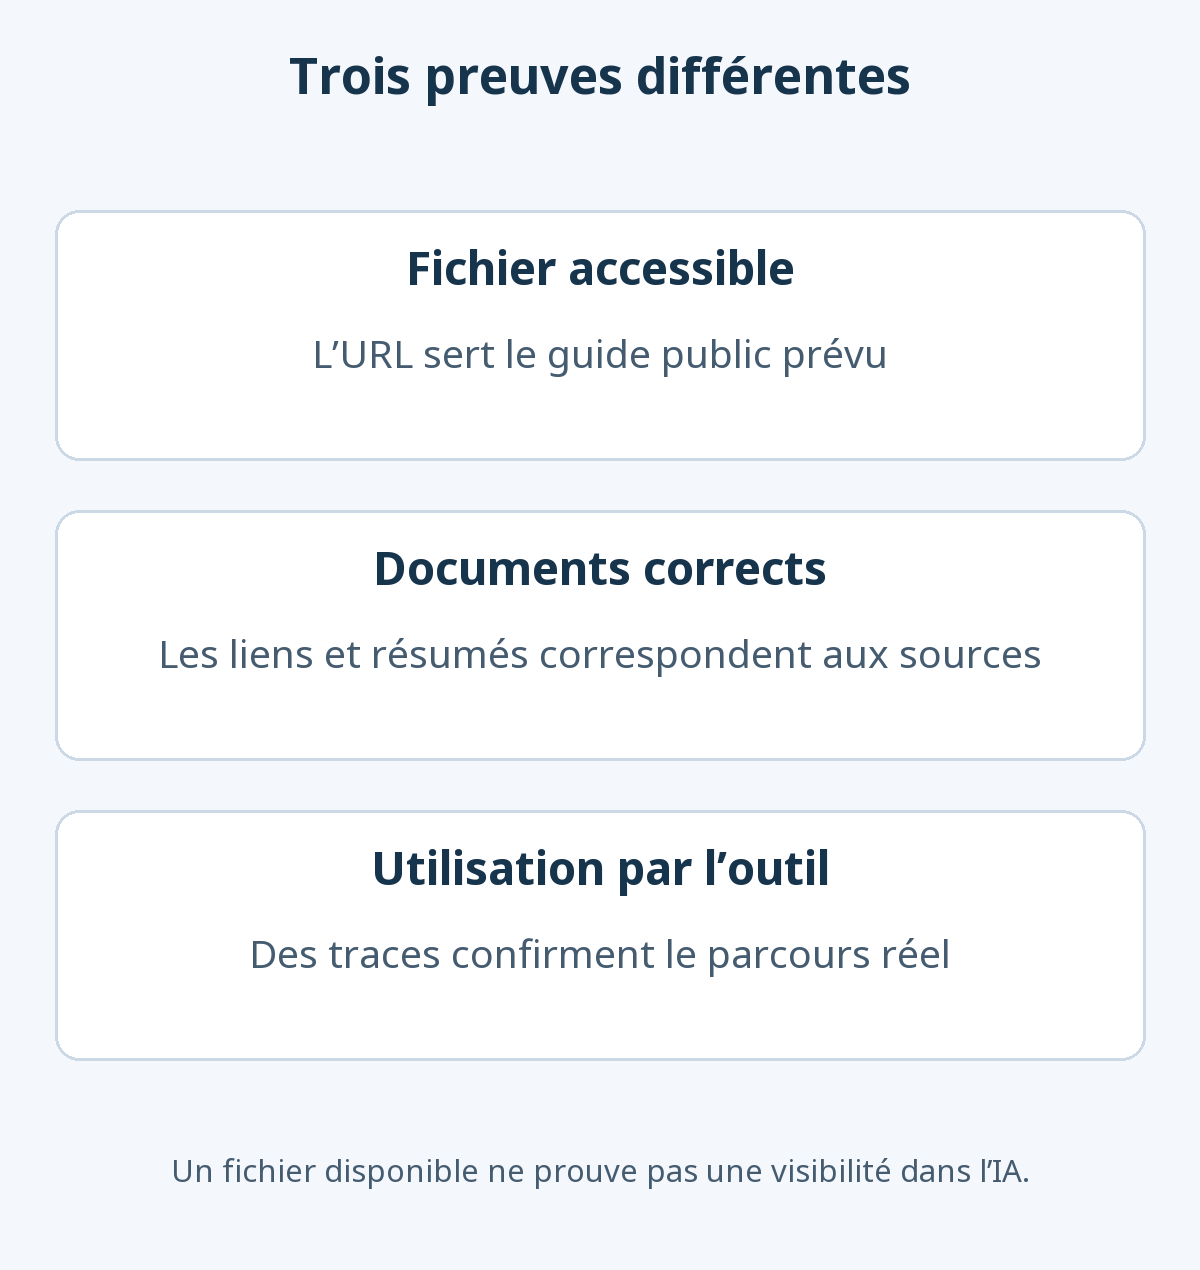
- Confirmez que l’adresse sert le guide Markdown prévu, sans afficher une page de connexion ou d’erreur. Ouvrez les liens répertoriés et comparez les titres des documents ainsi que leurs conditions d’application.
- Utilisez un outil qui prend explicitement en charge le fichier pour retrouver un document nécessaire. S’il expose un historique de récupération ou des chemins de citation, distinguez la lecture de l’index de celle des sources liées. Sans ces éléments, ne prétendez pas avoir confirmé l’utilisation réelle.
- Actualisez la liste et les résumés lorsque les sources changent ou déménagent. Si vous ne pouvez plus entretenir le fichier, retirez la version périmée et vérifiez les références qui pointent vers elle.
Le schéma distingue la mise à disposition du fichier, ses liens documentaires et l’usage par l’outil. Consigner ce que chaque preuve établit évite de traiter l’existence d’un fichier accessible comme une preuve de visibilité dans l’IA.
N’insérez ni contenus privés, ni adresses d’administration, ni identifiants de connexion dans ce fichier. Un guide destiné à l’IA reste lisible par les visiteurs ordinaires lorsqu’il est publié à une adresse publique. Entretenez-le de manière ciblée lorsque des informations partageables répondent au besoin réel d’un outil compatible.