Cara Membuka Akses Blog untuk Crawler Pencarian ChatGPT
Agar blog dapat ditemukan melalui pencarian ChatGPT, periksa terlebih dahulu apakah OAI-SearchBot, crawler pencarian OpenAI, dapat mengaksesnya. Bot ini berbeda dari GPTBot yang digunakan untuk pengumpulan konten yang mungkin dipakai melatih model, sehingga izin pencarian dan pelatihan dapat diatur secara terpisah. Mengizinkan akses crawler tidak menjamin blog akan muncul atau dikutip dalam jawaban tertentu.
Bedakan crawler pencarian dan pelatihan
Crawler adalah program yang mengambil halaman web secara otomatis. OpenAI menggunakan nama agen pengguna atau user agent yang berbeda untuk tujuan berbeda. Informasi ini memperkenalkan program yang mengirim permintaan, dan nama tersebut dapat digunakan pemilik situs untuk menyatakan kebijakan akses.
| Nama | Tujuan utama | Hal yang perlu dibedakan |
|---|---|---|
| OAI-SearchBot | Pengumpulan otomatis untuk hasil pencarian ChatGPT | Kebijakan akses pencarian |
| GPTBot | Pengumpulan konten yang mungkin digunakan untuk melatih model dasar | Izin pengumpulan untuk pelatihan |
| ChatGPT-User | Kunjungan yang dipicu oleh permintaan pengguna | Perilakunya berbeda dari crawler pencarian otomatis |
Dokumentasi resmi crawler OpenAI menjelaskan bahwa pengaturan pencarian dan pelatihan bersifat independen. Aturan robots.txt juga mungkin tidak berlaku untuk kunjungan yang dimulai atas permintaan pengguna. Karena itu, memblokir GPTBot saja tidak berarti mengendalikan seluruh jenis akses yang terkait dengan ChatGPT.
Dokumentasi tersebut membedakan jawaban pencarian dari tautan navigasi. Situs yang menolak OAI-SearchBot tidak ditampilkan dalam jawaban pencarian, tetapi masih dapat muncul sebagai tautan navigasi. Adanya tautan saja bukan bukti bahwa isi halaman berhasil diambil. Kunjungan ChatGPT-User juga tidak menentukan kelayakan situs untuk Pencarian.
Catat pengaturan akses publik saat ini
Tentukan kebijakan sebelum mengubah pengaturan: apakah situs boleh ditemukan melalui pencarian, apakah pengumpulan untuk pelatihan diizinkan, dan materi mana yang harus tetap privat? Simpan robots.txt serta konfigurasi keamanan terkait agar dapat dipulihkan jika hasil perubahan tidak sesuai.
- Dalam keadaan keluar dari akun, buka artikel yang ingin ditemukan dan periksa apakah isinya dapat diakses.
- Buka
/robots.txtpada skema dan nama host publik yang benar. Cakupanhttps://example.com/robots.txtberbeda darihttps://www.example.com/robots.txt. - Periksa grup khusus OAI-SearchBot dan GPTBot, serta grup bawaan
User-agent: *yang digunakan jika tidak ada grup yang cocok dengan crawler tersebut. - Cari pemblokiran bot lain pada hosting, plugin keamanan, atau jaringan pengiriman konten.
Situs WordPress dapat menyajikan robots.txt melalui berkas fisik di server, plugin, atau respons yang dibuat secara dinamis. Fungsi bawaan do_robots() pada WordPress, misalnya, menghasilkan respons robots.txt yang dapat disaring oleh komponen lain. Pastikan perubahan di panel administrasi benar-benar terlihat pada respons publik. Kenali komponen yang mengelolanya, tanpa menganggap situs pasti memakai plugin tertentu.
Baca contoh yang mengizinkan pencarian dan menolak pelatihan
Contoh berikut mengizinkan akses pencarian ke konten publik sekaligus menolak pengumpulan oleh GPTBot. Ini bukan berkas pengganti lengkap yang cocok untuk semua situs. Pertahankan deklarasi sitemap dan pembatasan yang masih diperlukan, lalu gabungkan aturan sesuai kebijakan situs.
User-agent: OAI-SearchBot
Allow: /
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-agent: GPTBot
Disallow: /
Grup OAI-SearchBot di atas turut memuat pembatasan /wp-admin/ dan pengecualian admin-ajax.php yang lazim pada WordPress. Periksa apakah aturan itu sesuai dengan kebutuhan situs Anda. Aturan Disallow yang lebih spesifik tetap dapat berlaku meskipun ada Allow: /. Sementara itu, Disallow: / pada grup GPTBot menyatakan bahwa pengumpulan tidak diizinkan untuk seluruh jalurnya. Tambahkan pengecualian lain yang diperlukan, misalnya jalur khusus anggota, secara terpisah.
Jangan menganggap grup khusus otomatis mewarisi pembatasan dalam User-agent: *. Aturan pemilihan grup dalam standar robots.txt menggunakan grup bawaan ketika tidak ada grup agen yang cocok. Jika grup bawaan mengecualikan jalur tertentu, periksa kembali apakah pembatasan yang dibutuhkan juga tercantum dalam grup OAI-SearchBot. Materi privat tetap harus dilindungi dengan autentikasi dan otorisasi, terlepas dari aturan crawler.
Contoh ini dapat dibaca sebagai berikut. Penjelasan ini merupakan interpretasi aturan, bukan hasil pengamatan atas permintaan dari server OpenAI:
- OAI-SearchBot pada artikel publik biasa: diizinkan, kecuali ada pembatasan yang lebih spesifik.
- OAI-SearchBot pada jalur di bawah
/wp-admin/: ditolak oleh pembatasan tersebut. - OAI-SearchBot pada
/wp-admin/admin-ajax.php: pengecualian yang lebih spesifik berlaku. - GPTBot pada jalur artikel: pengumpulan untuk pelatihan ditolak berdasarkan kebijakan.
RFC 9309 menggabungkan aturan jika beberapa grup cocok dengan agen yang sama, kemudian menerapkan aturan jalur cocok yang paling spesifik. Jangan membacanya sebagai “baris terakhir selalu menang”.
Sebelum menyimpan, cari grup lain untuk agen yang sama dan selesaikan duplikasi atau pertentangannya. Setelah menyimpan, periksa cache dan buka lagi /robots.txt publik untuk membandingkan respons dengan kebijakan yang diinginkan. Jika berbeda, pulihkan berkas serta pengaturan awal, lalu telusuri komponen yang mengelola respons tersebut.
Menurut OpenAI, sistemnya dapat memerlukan sekitar 24 jam untuk menyesuaikan perubahan robots.txt. Waktu ini berkaitan dengan pembaruan aturan akses, bukan janji bahwa halaman akan ditemukan atau dikutip dalam 24 jam.
Izin robots.txt belum tentu membuat permintaan berhasil
Izin dalam robots.txt dan penerimaan permintaan oleh server adalah dua hal berbeda. Firewall, perlindungan bot, kewajiban login, atau kesalahan koneksi masih dapat menghalangi pengambilan halaman. Jika tersedia log pemblokiran, periksa URL yang terdampak, waktu kejadian, dan nama aturan yang memblokir.
Jaringan pengiriman konten atau content delivery network (CDN) menyajikan sumber daya dari lokasi yang dekat dengan pengunjung. CDN juga dapat menerapkan aturan bot sebelum permintaan mencapai hosting. Respons 403, halaman login, atau tantangan verifikasi yang tercatat di log perlu diperiksa di luar konfigurasi robots.txt.
Hindari menjadikan “matikan seluruh perlindungan bot” sebagai langkah pertama. Temukan aturan pemblokiran yang relevan dan sesuaikan hanya cakupan yang diperlukan. Mengganti nama user agent pada permintaan uji tidak membuktikan bahwa permintaan itu berasal dari OpenAI. Cocokkan pula rentang alamat IP resmi yang ditautkan dalam dokumentasi OAI-SearchBot dengan metode verifikasi permintaan dari penyedia layanan. Gunakan daftar resmi terbaru, bukan salinan alamat yang dianggap berlaku selamanya.
Halaman yang terbuka pada browser Anda belum tentu memberikan respons yang sama kepada crawler. Sebaliknya, satu permintaan otomatis yang diblokir tidak membuktikan bahwa semua pembaca atau crawler terblokir. Catat permintaan apa yang diuji dan dalam kondisi apa pengujian dilakukan.
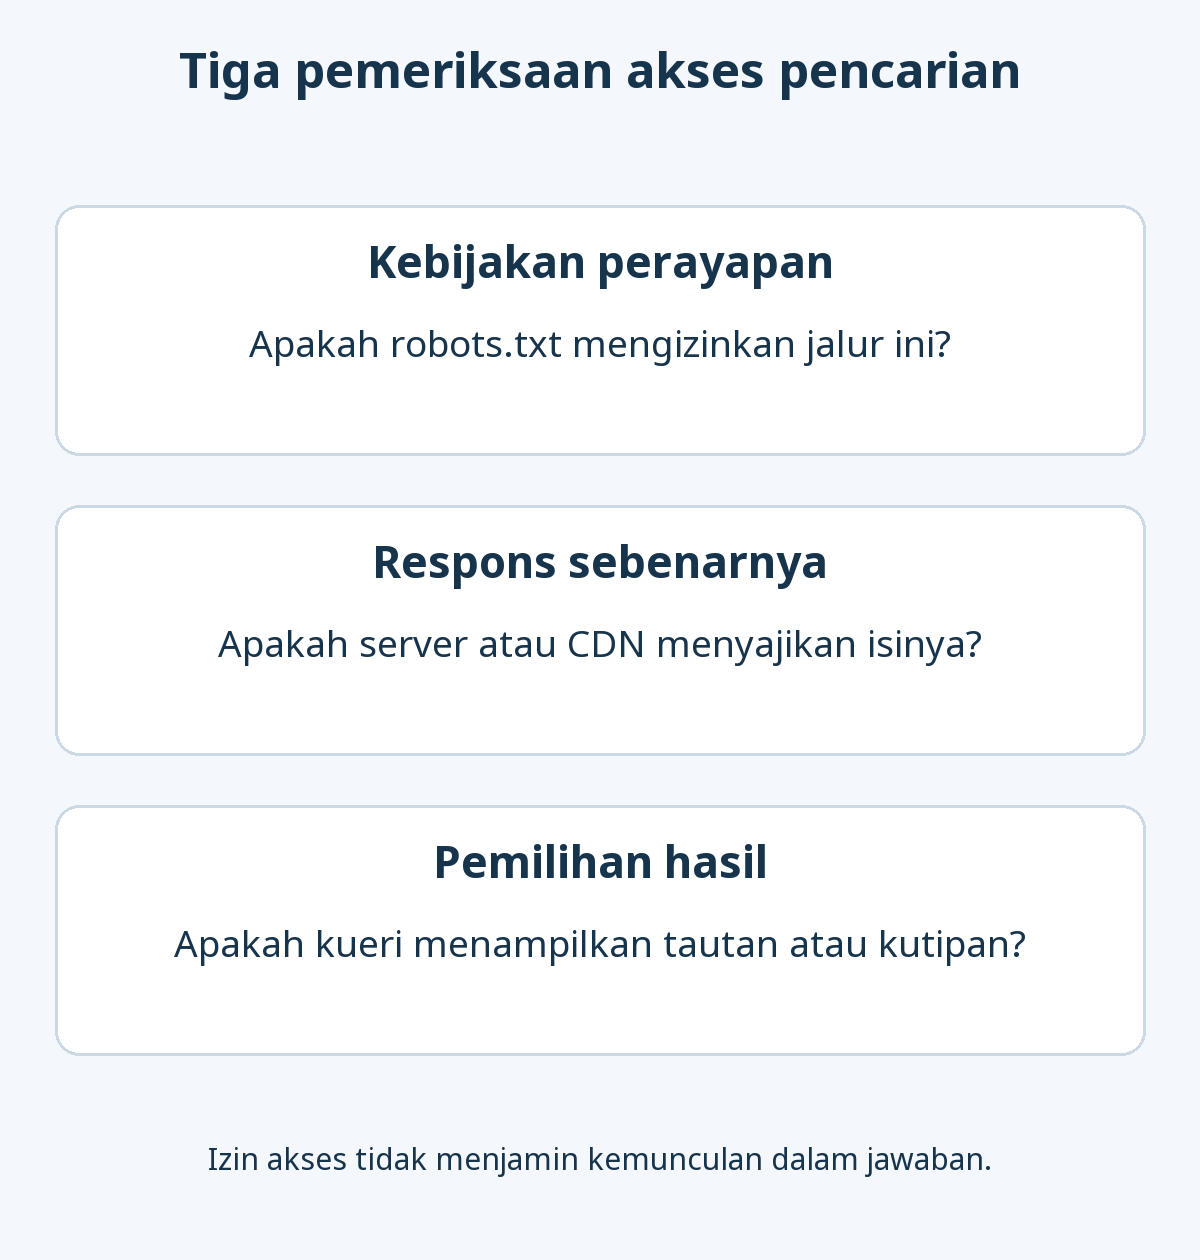
Kebijakan perayapan, respons yang benar-benar disajikan, dan pemilihan hasil pencarian perlu diperiksa secara terpisah. Diagram berikut membantu menunjukkan bagian mana yang sudah terbukti dan bagian mana yang masih belum diketahui.
Pisahkan pengaturan akses dari kemunculan dalam pencarian
Setelah akses diatur, tinjau isi halaman dan struktur tautannya. Apakah jawaban utama tersedia untuk publik? Bisakah pembaca mencapainya dari artikel atau kategori yang relevan? Apakah judul sesuai dengan isi? Izin pencarian bukan tombol yang memaksa tautan muncul pada setiap jawaban.
Catat “robots.txt memberikan respons”, “aturan yang dimaksud disajikan”, “isi publik dapat diakses”, dan “ditemukan dalam pencarian” sebagai hasil berbeda. Hasil terakhir dapat berubah menurut rumusan kueri dan waktu pencarian. Satu pencarian tidak cukup untuk menyimpulkan bahwa konfigurasi akses berhasil atau gagal.
Dokumentasi crawler menjelaskan peran akses; bukti bahwa suatu halaman benar-benar diambil memerlukan catatan server atau CDN yang dapat dipercaya. Untuk bagian konten, baca peran SEO, AEO, dan GEO dalam menyusun konten yang bermanfaat. Pisahkan masalah pengambilan halaman dari penilaian apakah artikelnya menjawab pertanyaan dan layak dijadikan rujukan.
Untuk pengindeksan Google, lihat cara memeriksa status indeks artikel di Search Console. Status indeks Google tidak dapat digunakan sebagai pengganti pemeriksaan kemunculan di pencarian ChatGPT, begitu pula sebaliknya.
Jangan jadikan robots.txt sebagai batas keamanan
Robots.txt adalah pernyataan kebijakan perayapan yang terbuka untuk publik, bukan mekanisme autentikasi bagi materi privat. Pengantar robots.txt dari Google juga menjelaskan bahwa tidak semua crawler mengikuti aturannya. Lindungi konten anggota dan informasi administrasi melalui autentikasi serta izin akses.
Simpan berkas yang diubah, aturan keamanan terkait, dan respons publik yang benar-benar diterima agar jelas apa yang perlu dipulihkan bila terjadi masalah. Menetapkan cakupan pencarian publik serta batas materi privat terlebih dahulu membantu menghindari perluasan akses yang tidak perlu ketika menyelidiki kemunculan situs.