怎样让 ChatGPT 搜索爬虫访问博客?检查 robots.txt 与服务器响应
要让博客具备被 ChatGPT 搜索发现的访问条件,应先检查 OpenAI 的搜索爬虫 OAI-SearchBot 能否访问网站。它与负责收集可能用于模型训练的内容的 GPTBot 用途不同,因此可以分别设置搜索和训练的访问规则。允许爬虫访问,并不保证网站一定出现在某个回答中或被引用。
先区分搜索爬虫与训练爬虫
爬虫是自动获取网页的程序。OpenAI 为不同用途使用不同的用户代理(user agent)名称。用户代理是请求程序用来表明身份的信息,网站所有者可以针对这些名称声明访问规则。
| 名称 | 主要用途 | 需要区分的设置 |
|---|---|---|
| OAI-SearchBot | 为 ChatGPT 搜索结果自动收集内容 | 搜索访问规则 |
| GPTBot | 收集可能用于训练基础模型的内容 | 是否允许为训练而收集内容 |
| ChatGPT-User | 根据用户请求访问网页 | 与自动搜索爬虫不同的访问行为 |
OpenAI 官方爬虫文档说明,搜索和训练的设置相互独立。文档还指出,用户主动发起的访问可能不适用 robots.txt 规则。因此,仅阻止 GPTBot,不能理解为控制了所有与 ChatGPT 有关的访问。
官方文档也区分了搜索回答与导航链接:选择拒绝 OAI-SearchBot 的网站不会出现在搜索回答中,但仍可能以导航链接的形式出现。看到一个链接,不等于已经证明爬虫成功读取了页面正文。ChatGPT-User 的访问也不决定网站是否符合搜索的使用条件。
记录网站当前的公开访问设置
修改前先明确网站政策:是否希望内容被搜索发现?是否允许为训练收集内容?哪些资料必须保持私密?保存当前 robots.txt 和相关安全设置,方便在结果不符合预期时恢复。
- 在退出登录的状态下,打开希望被发现的文章,确认正文是否可以访问。
- 在网站实际使用的公开协议和主机名下打开
/robots.txt。https://example.com/robots.txt与https://www.example.com/robots.txt的适用范围不同。 - 检查 OAI-SearchBot、GPTBot 的专用规则组,以及没有匹配的专用规则组时使用的
User-agent: *默认规则组。 - 检查主机服务、安全插件或内容分发网络中是否另有机器人拦截规则。
WordPress 网站的 robots.txt 可能来自服务器上的实体文件、插件,也可能是动态生成的响应。例如,WordPress 核心函数 do_robots() 会生成可由其他组件过滤的 robots.txt 响应。不要只看后台设置是否保存成功,还要检查公开响应是否真的改变,并确定究竟由哪个组件管理它,而不是假定网站一定装有某个插件。
理解允许搜索、拒绝训练的示例规则
下面的示例允许搜索爬虫访问公开内容,同时拒绝 GPTBot 收集内容。它不是适合所有网站的完整替换文件。合并规则时,应保留现有站点地图声明和仍然需要的限制,再根据自己的网站政策调整。
User-agent: OAI-SearchBot
Allow: /
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-agent: GPTBot
Disallow: /
示例在 OAI-SearchBot 规则组中也加入了 WordPress 常见的 /wp-admin/ 限制和 admin-ajax.php 例外。请先确认它们是否适合您的网站。即使有 Allow: /,更具体的 Disallow 规则仍可能适用。GPTBot 规则组中的 Disallow: / 则表示不允许其收集任何路径的内容。其他必要的排除路径,例如会员专属区域,也应单独补充。
不要以为专用规则组会自动继承 User-agent: * 下的限制。robots.txt 标准的规则组选择方式是在没有匹配的用户代理规则组时,才使用默认组。如果默认组排除了某些路径,应确认 OAI-SearchBot 专用组也包含仍然需要的限制。无论如何,私密资料都需要通过身份验证与访问授权保护。
这个示例可以作如下解读。以下是规则含义的说明,并不是对 OpenAI 服务器真实请求的观察结果:
- OAI-SearchBot 访问普通公开文章:在没有更具体限制时允许访问。
- OAI-SearchBot 访问
/wp-admin/下的路径:被该限制禁止。 - OAI-SearchBot 访问
/wp-admin/admin-ajax.php:适用更具体的例外规则。 - GPTBot 访问文章路径:网站政策拒绝为训练收集内容。
RFC 9309 会合并多个匹配同一用户代理的规则组,再应用路径匹配最具体的规则。不要把它理解为“文件最后一行永远优先”。
保存前,先查找是否已经存在同一用户代理的规则组,处理重复或矛盾。保存后检查缓存,再次打开公开的 /robots.txt,比较实际返回的规则是否符合预期。若结果不同,应恢复原文件和设置,再排查管理响应的组件。
OpenAI 表示,系统可能需要约 24 小时来适应 robots.txt 的修改。这个时间指访问规则的更新,并不是承诺网页会在 24 小时内被发现或引用。
robots.txt 允许访问,实际请求仍可能失败
robots.txt 声明允许,与服务器实际接受请求,是两项不同的检查。防火墙、机器人防护、登录要求或连接错误,都可能妨碍抓取。如果服务提供拦截日志,应检查受影响的 URL、发生时间,以及具体命中的规则名称。
内容分发网络(content delivery network,CDN)会从靠近访问者的位置提供资源,也可能在请求到达主机之前执行机器人规则。因此,日志中的 403 响应、登录页或验证挑战,可能需要从 robots.txt 以外的设置排查。
不宜一开始就关闭所有机器人防护。应先找到实际造成拦截的规则,只调整必要范围。把测试请求的用户代理名称改成 OpenAI 爬虫的名称,并不能证明请求来自 OpenAI。还应结合服务商的请求验证方法,核对 OAI-SearchBot 文档链接的官方 IP 地址范围。应使用最新官方列表,不要把从示例复制的地址当作永久不变的地址。
页面在自己的浏览器里可以打开,并不保证爬虫收到同样的响应。反过来,一次自动请求被拦截,也不能证明所有读者或爬虫都被拦截。记录测试的是哪一种请求,以及测试所处的条件。
抓取政策、实际提供的响应,以及搜索是否选择该内容,需要分别检查。下图将它们分开,帮助判断哪些已经得到证实,哪些仍未确定。
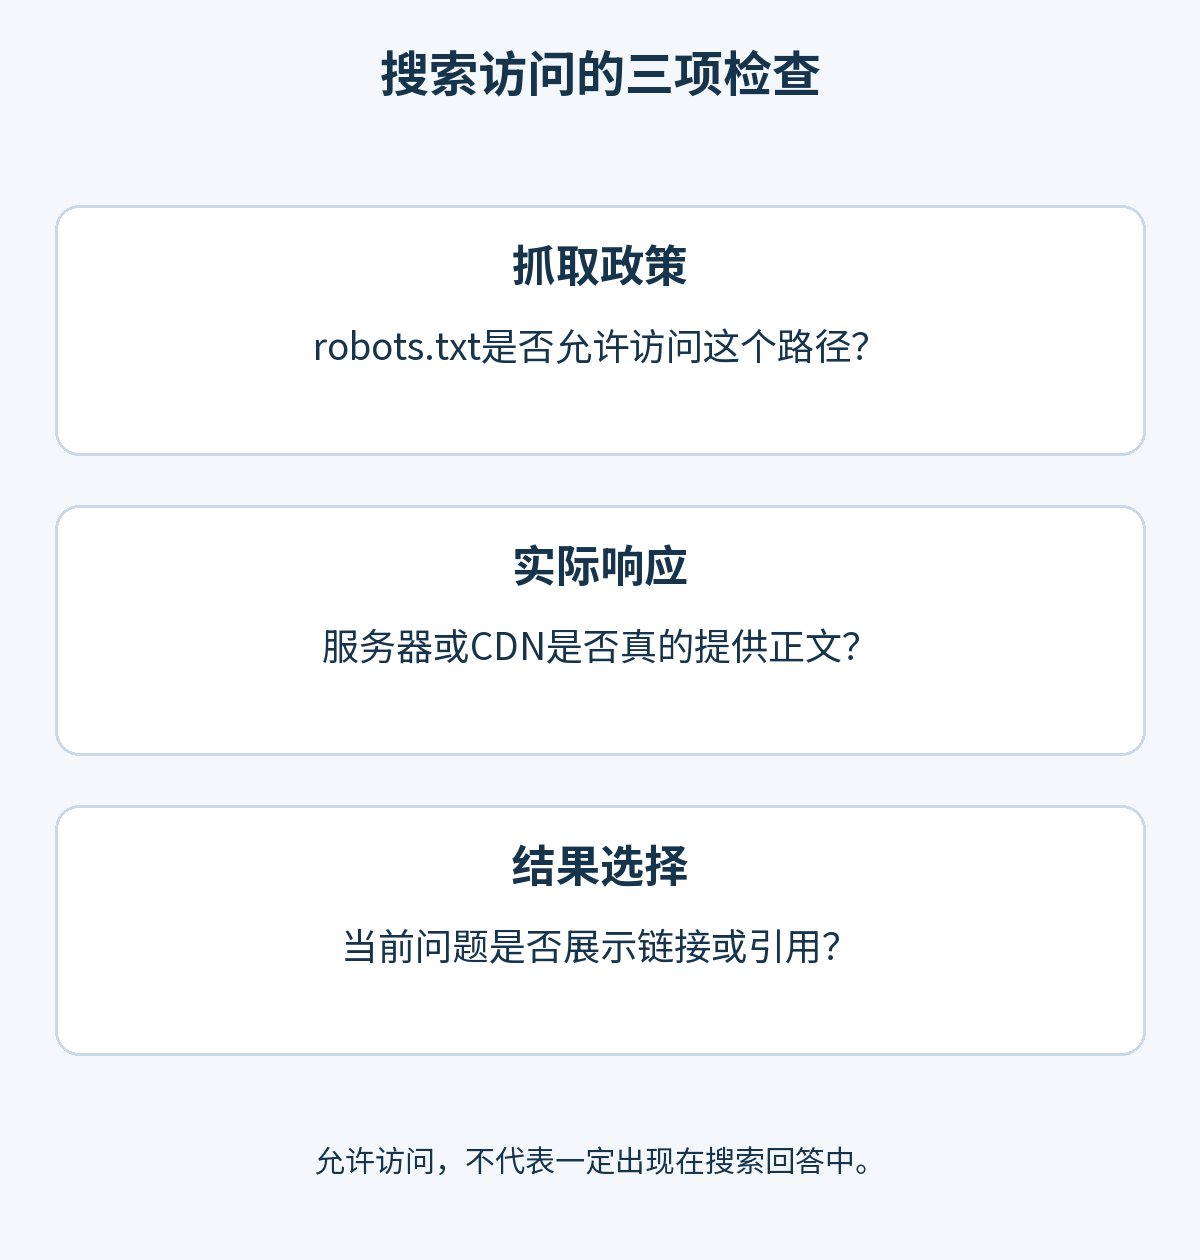
把访问配置与搜索展示分开判断
配置访问权限后,还要检查页面内容和链接结构。核心答案是否公开可读?读者能否从相关文章或分类找到这篇文章?标题与正文是否一致?允许搜索访问,并不会出现一个开关,让链接在每个回答里都展示。
应分别记录“robots.txt 有响应”“实际提供了预期规则”“公开正文可访问”和“搜索中找到了网站”。最后一项会随问题的表达方式和搜索时间变化,所以不能仅凭一次搜索,就可靠地判断访问配置是否成功。
爬虫文档说明的是访问条件;要证明正文确实被抓取,还需要可信的服务器或 CDN 记录。内容方面可以参考SEO、AEO 与 GEO 在组织实用内容时的作用。应把访问问题与文章是否提供了值得引用的答案分开检查。
如果要检查 Google 的索引状态,可以阅读如何在 Search Console 检查文章是否被编入索引。Google 的索引状态与 ChatGPT 搜索的展示情况,不能相互替代。
不要把 robots.txt 当作安全边界
Robots.txt 是公开声明的抓取政策,不是保护私密资料的身份验证机制。Google 的 robots.txt 入门说明也指出,并非所有爬虫都会遵守规则。会员内容和管理信息应通过身份验证与权限控制保护。
将修改后的文件、相关安全规则和实际公开响应一并保存,发生问题时才能清楚知道需要恢复哪些内容。先界定哪些内容允许公开搜索、哪些内容必须受到保护,有助于避免在排查搜索展示问题时,不必要地扩大访问范围。