GPT-6.1 Sol 是什么?功能、API 价格及与 GPT-6 Sol 的区别
GPT-6.1 Sol 是 OpenAI 为复杂编程、计算机操作和专业工作设计的语言模型,重点是平衡能力与成本。OpenAI 称其以更低价格提供接近 Astra 的表现,但不代表每项任务都能达到同样水平。实际需要判断的是,它能否以可接受的修改时间和总成本满足你的质量要求。
选模型应看工作需求,而不只是名称。分类数千条短记录,与综合多份资料写出可发布文章,对准确性、推理和复核的要求不同。
GPT-6.1 Sol 适合做什么?
GPT-6.1 Sol 面向需要理解上下文并交付有用结果的工作,而非只生成流畅文字。OpenAI 的模型选择指南举例包括根据财务结果制作董事会演示,或根据产品需求说明搭建网站。
以下是潜在用途,不是本文实际评测结果,也不表示它总胜过其他模型:
- 编程:理解要求、检查现有代码、提出修改和准备测试。建议修复仍须在相关环境执行、验证。
- 文档分析:从多个文件找出共同结论与差异,形成报告或比较。应指定允许使用的来源,并禁止无依据补充。
- 多步骤工具调用:搜索信息、查看文件,再经过多个步骤形成结果。这通常称为智能体工作流程,即模型借助工具完成任务。应用提供的工具和权限,决定实际能做什么。
对博主而言,它可能帮助整理比较标准或综合官方文档。不过,文字漂亮并不能证明主张准确,仍须核对来源并作编辑判断。
来源:OpenAI 模型选择指南。
输入、输出与主要规格
应用程序编程接口(API)让软件直接调用模型。下表描述 API 模型,而非所有提供该模型的应用订阅功能或使用额度。
| 项目 | GPT-6.1 Sol | 含义 |
|---|---|---|
| 模型 ID | gpt-6.1-sol | API 请求使用的标识。 |
| 输入 | 文字与图片 | 请求可包括书面指令与支持的图片输入。 |
| 输出 | 文字 | 通过工具生成图片,与模型直接输出的类型不同。 |
| 上下文窗口 | 1,050,000 token | 请求可用的上下文空间,包括相关输入和输出。 |
| 预留最大输出后的剩余空间 | 922,000 token | 从上下文减去最大输出得到的计算值,并非在所核对官方文档中另行确认的固定输入上限。 |
| 最大输出 | 128,000 token | 包括生成的推理;实际输出取决于请求设置与可用上下文。 |
| 知识截止日期 | 2026 年 4 月 30 日 | 更新的事实需要实时来源或检索工具。 |
| 直接音频与视频 | 不支持 | 通过其他流程转写音频或提取视频帧,不等于原生音频、视频输入。 |
上述剩余空间以预留全部最大输出为前提,是算术示例,不是已验证的额外官方输入限制。Token 是模型处理和计费输入、输出的单位,并不固定对应某个字数或字符数。用量随语言与内容变化,不能把上下文窗口直接换算成保证可处理多少页。
大上下文也不保证每个细节都被正确找出。应移除无关文件,区分待分析材料与辅助参考,并要求指出重要证据的位置。长输入会影响费用,也可能增加复核难度。
来源:GPT-6.1 Sol 规格。
API 价格与计算示例
普通输入、缓存读取、缓存写入和输出分别计价。重复同一提示词,不表示全部输入都会自动获得缓存价。应检查适用缓存机制与实际用量。
| 计费类别 | 标准价,美元/百万 token |
|---|---|
| 输入 | US$2.00 |
| 缓存输入读取 | US$0.10 |
| 缓存写入:默认 30 分钟 | US$2.50 |
| 缓存写入:12 小时 | US$5.00 |
| 输出 | US$10.00 |
缓存读取是复用已保存输入,缓存写入则是存储输入供后续可能复用。官方缓存指南规定,GPT-6.1 Sol 的读取价为普通输入的 5%,默认 30 分钟写入为 1.25 倍,可选 12 小时写入为 2.5 倍。若前缀写入后从未复用,反而可能更贵,因此应评估上下文是否真正重复。
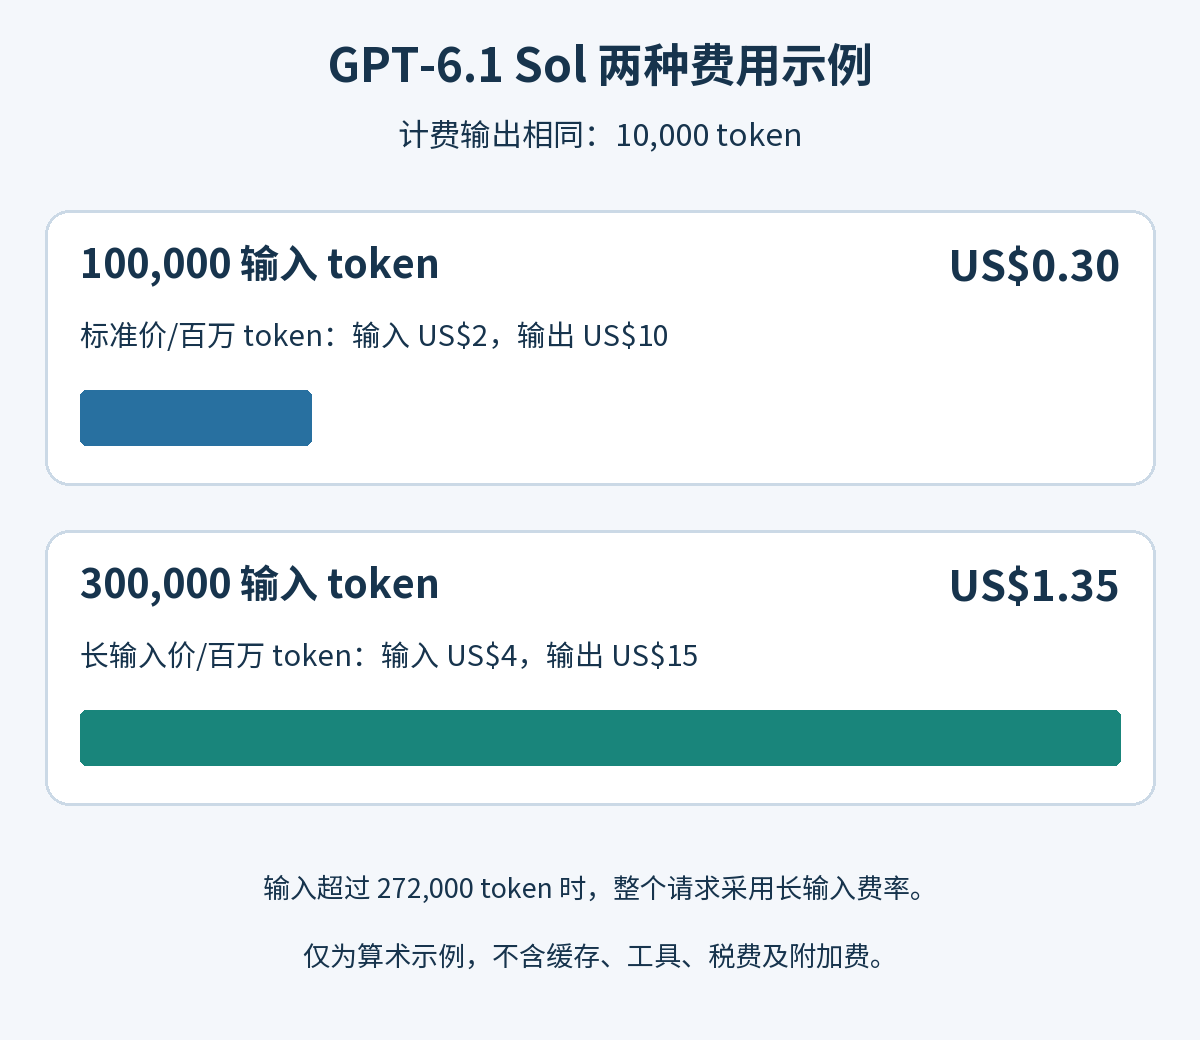
一项标准请求若包含 100,000 个普通输入 token 与 10,000 个计费输出 token,输入费为 US$0.20,输出费 US$0.10,合计 US$0.30。示例不含缓存费用、工具、税费、处理模式或地区附加费,也不是每篇文章的固定成本。
推理 token 按输出收费。Responses API 的 output_tokens 已包含推理,output_tokens_details.reasoning_tokens 则显示其中推理部分,不能再加一次。应看返回用量,而非只看可见回答长度。max_output_tokens 太小,可能在可见回答完成前就出现 incomplete 状态。评估任务总成本时,还应检查完成状态,以及重试、搜索、修订和人工复核。
输入统计也须分开普通输入、缓存读取、30 分钟写入与 12 小时写入。如果把整个 usage.input_tokens 按普通输入收费,再叠加缓存费用,就会重复计算。官方用量字段区分 cached_tokens、cache_write_tokens 及按存活时间划分的写入量;总输入减去读取和写入后,才是普通输入。
长输入价格适用于整个请求
当输入超过 272,000 token,输入及缓存费率变成标准价两倍,输出费率为 1.5 倍。调整适用于整个请求,而不只是超出门槛的部分。
例如,300,000 个普通输入 token 按每百万 US$4 计费,费用为 US$1.20;另有 10,000 个计费输出 token,按每百万 US$15 计费,费用为 US$0.15。合计 US$1.35,尚未加入其他适用费用。
下图比较 100,000 输入与 300,000 输入的两种情况,两者计费输出都是 10,000 token,但输入量与适用费率不同。这是算术说明,不是性能测试或真实账单。
拆分文档可能减少单次上下文,也可能隐藏文档之间的关系,或增加重复输入与摘要生成费。应按可靠回答需要的上下文组织材料,而非只盯着计费门槛。
处理模式与应用订阅不同
Fast 价格为 Standard 两倍,Ultrafast 为六倍,Batch 与 Flex 则比 Standard 低 50%,具体取决于可用性与运行条件。这是价格倍数,不是速度保证。需要立即回答的工作,与可以稍后完成的异步任务,应采用不同的延迟和排程考虑。
2026 年 10 月的官方指南列出,GPT-6.1 Sol 的 Fast 支持欧盟数据驻留,Ultrafast 支持美国和欧盟。数据驻留涉及按服务功能和资格限定的处理或存储地区。可用地区的区域处理另加 10% 费用。应核对地区、模式与账户设置的组合,不要把其他模型的驻留限制直接套用。
API token 价格与 ChatGPT、Codex 订阅价格不同。应用中的模型、工具和用量限制取决于账户、套餐,不能用 API 单价推断订阅额度。
来源:GPT-6.1 Sol 价格与处理模式,以及官方模型指南的地区兼容性说明。
与 GPT-6 Sol、Astra、Luna 有何区别?
名称相似,不代表能力、设置和价格相同。下表比较用途定位及标准 API 单价,并非性能评测。
| 模型 | 一般定位 | 输入 | 缓存读取 | 输出 |
|---|---|---|---|---|
| GPT-6.1 Sol | 复杂工作的能力与成本平衡。 | US$2.00 | US$0.10 | US$10.00 |
| GPT-6 Sol | 复杂编程与智能体工作。 | US$2.00 | US$0.20 | US$10.00 |
| GPT-6 Astra | 要求最高的工作。 | US$10.00 | US$1.00 | US$50.00 |
| GPT-6 Luna | 范围明确的高用量任务。 | US$0.10 | US$0.01 | US$0.50 |
以上为标准模式每百万 token 的美元价格,不含长输入倍数、工具与其他适用调整。Token 单价低,不一定代表完成任务更便宜:各模型可能需要不同 token 量、重试与修正次数。
在此比较中,GPT-6.1 Sol 缓存读取价是 GPT-6 Sol 的一半,但不意味着整个账单减半。收益取决于有多少输入享受缓存价,以及输出和其他费用占多少。
若要同时了解 GPT-5.6 系列,可阅读GPT-6 与 GPT-5.6 六款模型的用途和 API 成本比较,并配合最新官方规格、价格使用其选择标准。
推理设置与 API 兼容性要注意什么?
推理强度控制要求模型为解决问题投入多少努力。GPT-6.1 Sol 支持 low、medium、high、xhigh、max,默认 medium,不支持 none 或 minimal。
GPT-6 Sol 支持 none,因此不能只改模型名称就迁移。还要检查推理设置和工具调用兼容性。GPT-6.1 Sol 通过 Responses API 支持工具,Chat Completions 不支持其工具调用。
来源:OpenAI 最新模型使用指南。
可先以默认设置测试有代表性的任务,再按结果调整。在相同输入下比较质量、修订需求、延迟与计费用量。同时更换模型与推理设置,会增加定位差异原因的难度。
从 GPT-6 Sol 迁移时检查什么?
更换前,保存可用请求配置与有代表性的成功案例,作为回退点。以下是检查流程,不是本文实际执行过的迁移测试。
- 匹配模型与设置。把
model设为gpt-6.1-sol前,检查原推理强度是否受支持。若旧配置使用不受目标模型支持的none或minimal,官方指南建议从low开始,再比较代表性任务。 - 检查端点与工具。需要工具时使用 Responses。区分有工具、无工具请求,并验证完整响应和工具结果之后的继续执行。
- 移除不支持的参数。本模型必须启用推理;按指南检查
temperature、top_p、top_logprobs,也要检查 Chat Completions 的logprobs,以及 Responses 的include中的message.output_text.logprobs。 - 比较完成情况与用量。以相同材料记录准确性、输出格式、工具行为、完成状态和输入、缓存、输出用量。如果新配置失败,先恢复已保存配置,再隔离变更后重试。
文章工作可提供相同官方资料与问题,再按一致的事实核查流程比较主张、数字与条件。一次改一个变量,更容易判断差异来自模型、提示词、推理强度还是工具。
哪些人值得评估 GPT-6.1 Sol?
以下建议是评估起点,并非固定规则或本文测试结果。
| 情况 | 候选与理由 | 检查重点 |
|---|---|---|
| 成本重要的复杂文章、文档分析或编程。 | 评估 GPT-6.1 Sol 的能力与价格平衡。 | 质量、修订需求、完成任务的总成本。 |
| 高用量的简单分类或提取。 | 先评估 Luna,再决定是否支付更强模型费用。 | 例外与困难输入,而非只看简单案例。 |
| 证据相互冲突,或失败代价高。 | 以实际工作比较 Astra 与 GPT-6.1 Sol。 | 来源依据、错误严重性和必要专业复核。 |
| 现有 GPT-6 Sol 流程已可靠运行。 | 迁移前评估 GPT-6.1 Sol。 | 兼容性、输出格式,以及原本成功案例是否退步。 |
来源:OpenAI 模型选择指南。
对博客流程,可让候选模型使用相同大纲和资料,检查草稿是否回答标题承诺的问题、是否有错误或无依据主张,以及需要多少编辑。篇幅和自信语气都不能替代这些检查。
限制与实用评估清单
GPT-6.1 Sol 不能替代验证。处理最新信息,应查看原始来源并核对数字、链接。法律、金融、健康等错误可能造成严重损害的内容,仍需要适当专家复核。
工具权限也要单独审视。发布内容、删文件、付款、发消息可能带来难以撤销的后果,应设置审批、日志与明确停止条件。模型能力提高,不会自动构成扩大权限的理由。
- 准备代表性案例。包括容易和困难任务,去除不必要的敏感资料。
- 先定义合格标准。比较前确定准确性、输出格式、证据要求与可接受时间。
- 控制比较条件。使用相同输入、工具,记录错误与重试,而非只看最终回答。
- 比较合格结果的成本。在满足要求的候选中,考虑总 API 用量与人工纠错时间。
- 检查退步。更换模型或设置后,重跑原本成功的案例。
当复杂工作需要强能力,又希望低于 Astra 的标准 token 单价时,GPT-6.1 Sol 值得评估。简单任务可能更适合轻量模型,特别困难的工作则值得直接比较。真正有用的选择,应由自身任务的质量、时间与总成本结果支持。