Che cos'è GPT-6.1 Sol? Funzioni, prezzi API e differenze da GPT-6 Sol
GPT-6.1 Sol è un modello linguistico OpenAI pensato per bilanciare capacità e costi nella programmazione complessa, nell'uso del computer e nel lavoro professionale. OpenAI lo descrive come vicino ad Astra a un prezzo inferiore, ma non significa che lo eguagli in ogni compito. La domanda pratica è se soddisfa i tuoi requisiti con tempi di revisione e costi complessivi accettabili.
Scegli il modello per il lavoro da svolgere, non soltanto per il nome. Classificare migliaia di voci brevi e preparare un articolo pubblicabile da più fonti richiede precisione, ragionamento e controlli differenti.
Fonte: documentazione ufficiale di GPT-6.1 Sol.
Per quali attività è utile GPT-6.1 Sol?
GPT-6.1 Sol è destinato a lavori che richiedono comprensione del contesto e un risultato utilizzabile, non soltanto testo scorrevole. La guida OpenAI alla scelta del modello cita una presentazione per il consiglio di amministrazione ricavata da risultati finanziari o un sito realizzato da una descrizione di prodotto.
Questi sono impieghi possibili, non risultati di nostri test né affermazioni di superiorità universale:
- Programmazione: interpretare requisiti, esaminare codice, proporre modifiche e preparare test. Le correzioni vanno comunque eseguite e verificate nell'ambiente pertinente.
- Analisi documentale: individuare risultati comuni e differenze tra file, quindi produrre un rapporto o confronto. Definisci le fonti ammesse e vieta aggiunte prive di riscontro.
- Uso di strumenti in più passaggi: cercare informazioni, esaminare file e produrre un risultato. Si parla spesso di flusso agentico: il modello svolge il compito con strumenti. Le azioni possibili dipendono dagli strumenti e dai permessi forniti dall'applicazione.
Per un blogger può essere utile organizzare criteri di confronto o sintetizzare documenti ufficiali. Un paragrafo ben scritto, però, non prova la correttezza delle affermazioni. Restano necessari verifica delle fonti e giudizio editoriale.
Fonte: guida OpenAI alla scelta del modello.
Input, output e specifiche principali
Un'interfaccia di programmazione delle applicazioni (API) permette al software di richiamare direttamente il modello. Le specifiche descrivono il modello API, non funzioni di abbonamento o limiti d'uso di tutte le applicazioni che lo offrono.
| Voce | GPT-6.1 Sol | Significato |
|---|---|---|
| ID del modello | gpt-6.1-sol | Identificatore usato nelle richieste API. |
| Input | Testo e immagini | Puoi includere istruzioni scritte e immagini nei formati supportati. |
| Output | Testo | La generazione di immagini tramite strumenti è distinta dall'output diretto del modello. |
| Finestra di contesto | 1.050.000 token | Spazio disponibile per la richiesta, inclusi gli input e output pertinenti. |
| Spazio residuo riservando l'output massimo | 922.000 token | Calcolo ottenuto sottraendo l'output dal contesto, non un limite fisso di input verificato separatamente nella documentazione ufficiale. |
| Output massimo | 128.000 token | Include il ragionamento generato; il risultato effettivo dipende dalle impostazioni e dal contesto disponibile. |
| Limite delle conoscenze | 30 aprile 2026 | I fatti più recenti richiedono fonti aggiornate o strumenti di ricerca. |
| Audio e video diretti | Non supportati | Trascrivere audio o estrarre fotogrammi con una procedura separata non equivale a input audio o video nativi. |
Lo spazio residuo è un esempio aritmetico che riserva tutto l'output massimo, non un ulteriore tetto ufficiale di input confermato. I token sono unità per elaborare e fatturare input e output, non un numero fisso di parole o caratteri. Il consumo varia con lingua e contenuto, quindi il contesto non si traduce in un numero garantito di pagine.
Un contesto ampio non assicura che ogni dettaglio venga recuperato perfettamente. Escludi file irrilevanti, separa il materiale da analizzare dalle fonti di supporto e chiedi di localizzare le prove importanti. Input lunghi incidono su costi e difficoltà di controllo.
Fonte: specifiche di GPT-6.1 Sol.
Prezzi API ed esempi di calcolo
Input ordinario, letture dalla cache, scritture nella cache e output hanno prezzi distinti. Ripetere un prompt non rende automaticamente tutto l'input idoneo al prezzo della cache. Verifica il funzionamento applicabile e i dati effettivi di utilizzo.
| Categoria | Prezzo Standard per 1 milione di token, USD |
|---|---|
| Input | US$2,00 |
| Input dalla cache | US$0,10 |
| Scrittura cache: 30 minuti predefiniti | US$2,50 |
| Scrittura cache: 12 ore | US$5,00 |
| Output | US$10,00 |
Una lettura riutilizza input conservato; una scrittura lo memorizza per un riuso potenziale. La guida ufficiale alla cache indica per GPT-6.1 Sol letture al 5% del prezzo ordinario, scritture predefinite di 30 minuti a 1,25 volte e scritture opzionali di 12 ore a 2,5 volte l'input ordinario. Un prefisso scritto e mai riutilizzato può costare di più: valuta se il contesto si ripete davvero.
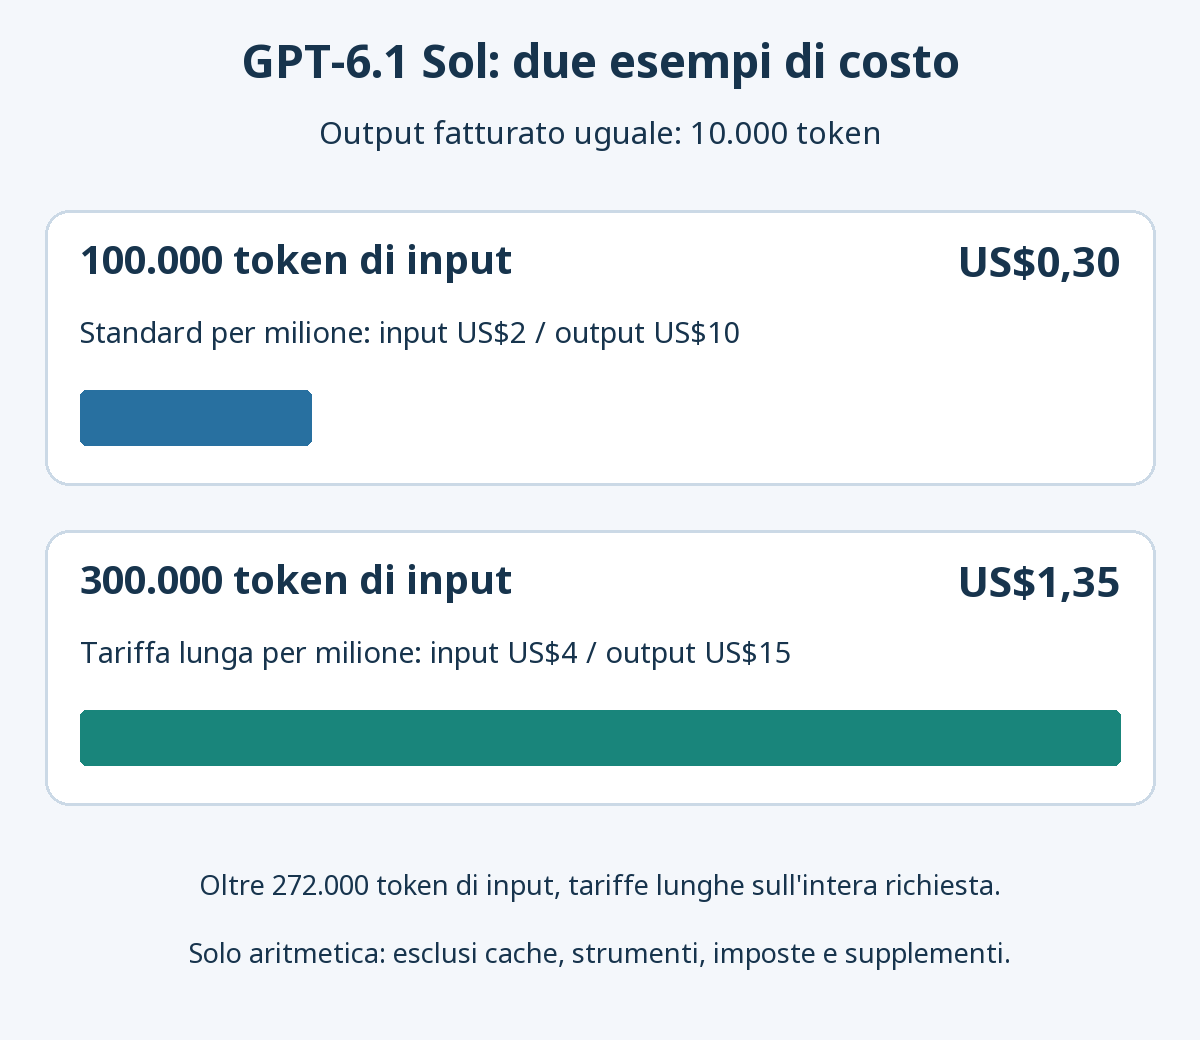
Una richiesta Standard con 100.000 token di input ordinario e 10.000 token di output fatturabile costa US$0,20 per l'input più US$0,10 per l'output: US$0,30 complessivi. L'esempio esclude cache, strumenti, imposte e supplementi di elaborazione o regione. Non è un prezzo fisso per articolo.
I token di ragionamento vengono fatturati come output. Nei dati Responses API, output_tokens li include già; output_tokens_details.reasoning_tokens ne specifica la parte. Sommarla di nuovo significa contarla due volte. Usa i dati restituiti, non la lunghezza del testo visibile. Un max_output_tokens insufficiente può produrre una risposta incomplete prima della conclusione visibile. Controlla stato e costo; nel totale del compito contano anche tentativi, ricerche, revisioni e controllo umano.
Fonti: prezzi OpenAI API e guida OpenAI al ragionamento.
Anche il conteggio dell'input richiede di separare input ordinario, letture, scritture di 30 minuti e di 12 ore. Addebitare tutto usage.input_tokens come input ordinario e aggiungere la cache comporta un doppio conteggio. I campi ufficiali distinguono cached_tokens, cache_write_tokens e ripartizione delle scritture per durata. L'input ordinario è quanto resta del totale dopo aver sottratto letture e scritture.
Le tariffe per input lunghi riguardano l'intera richiesta
Oltre 272.000 token di input, i prezzi di input e cache raddoppiano, mentre l'output costa 1,5 volte lo Standard. I moltiplicatori si applicano a tutta la richiesta, non soltanto ai token sopra la soglia.
Per esempio, 300.000 token di input ordinario costano US$1,20 alla tariffa adeguata di US$4 per milione. Altri 10.000 token di output fatturabile costano US$0,15 a US$15 per milione. Il totale è US$1,35, prima di altri oneri applicabili.
Il grafico confronta l'esempio con 100.000 token di input e quello con 300.000. Entrambi hanno 10.000 token di output fatturabile, ma quantità di input e tariffe differiscono. È un'illustrazione aritmetica, non una prova di prestazioni o una fattura reale.
Dividere i documenti può ridurre il contesto per richiesta, ma anche nascondere collegamenti o introdurre input ripetuti e costi di sintesi. Organizza i materiali secondo il contesto necessario a una risposta affidabile, non soltanto in base alla soglia.
Modalità di elaborazione e abbonamenti sono distinti
Fast costa il doppio dello Standard, Ultrafast sei volte, mentre Batch e Flex offrono prezzi inferiori del 50%, secondo disponibilità e condizioni operative. Sono moltiplicatori di prezzo, non velocità garantite. Considera latenza e pianificazione: una risposta immediata è diversa da un lavoro asincrono che può terminare più tardi.
La guida ufficiale di ottobre 2026 indica per GPT-6.1 Sol la residenza dei dati nell'Unione europea con Fast e negli Stati Uniti e nell'Unione europea con Ultrafast. La residenza riguarda le regioni di trattamento o conservazione secondo le funzioni e i requisiti del servizio. L'elaborazione regionale comporta un supplemento del 10% dove disponibile. Verifica combinazione di regione, modalità e account, senza estendere a questo modello i limiti di un altro.
I prezzi dei token API sono diversi dagli abbonamenti ChatGPT o Codex. Modelli, strumenti e limiti nelle applicazioni dipendono da account e piano. Le tariffe API non permettono di dedurre la quota inclusa nell'abbonamento.
Fonti: prezzi e modalità di GPT-6.1 Sol e guida ufficiale alla compatibilità regionale.
Come si confronta con GPT-6 Sol, Astra e Luna?
Nomi simili non implicano capacità, impostazioni o prezzi identici. La tabella confronta posizionamento e tariffe API Standard, non le prestazioni misurate.
| Modello | Posizionamento | Input | Cache | Output |
|---|---|---|---|---|
| GPT-6.1 Sol | Equilibrio tra capacità e costo per lavori complessi. | US$2,00 | US$0,10 | US$10,00 |
| GPT-6 Sol | Programmazione complessa e lavoro con agenti. | US$2,00 | US$0,20 | US$10,00 |
| GPT-6 Astra | I lavori più impegnativi. | US$10,00 | US$1,00 | US$50,00 |
| GPT-6 Luna | Compiti delimitati ad alto volume. | US$0,10 | US$0,01 | US$0,50 |
Prezzi in dollari statunitensi per 1 milione di token Standard, esclusi moltiplicatori per input lunghi, strumenti e altri adeguamenti. Un token più economico non significa sempre un compito meno costoso: token necessari, tentativi e correzioni possono variare.
In questo confronto, l'input dalla cache di GPT-6.1 Sol costa metà di quello di GPT-6 Sol. Non dimezza l'intera fattura: il beneficio dipende dalla quota di input idonea alla cache e dal peso di output e altri oneri.
Fonti: confronto dei modelli OpenAI e documentazione di GPT-6 Sol.
Per includere anche la famiglia GPT-5.6, consulta il confronto tra sei modelli GPT-6 e GPT-5.6 per impiego e costo API. Affianca i criteri alle specifiche e ai prezzi ufficiali attuali.
Attenzione a ragionamento e compatibilità API
Il livello di ragionamento controlla quanto impegno chiedi al modello nel risolvere il problema. GPT-6.1 Sol supporta low, medium, high, xhigh e max, con medium come impostazione predefinita. Non supporta none o minimal.
GPT-6 Sol supporta none: non migrare cambiando soltanto il nome. Verifica ragionamento e compatibilità degli strumenti. GPT-6.1 Sol permette di richiamare strumenti tramite Responses API; l'uso di strumenti non è supportato tramite Chat Completions.
Fonte: guida OpenAI ai modelli attuali.
Parti dall'impostazione predefinita su compiti rappresentativi e modificala se i risultati lo giustificano. Confronta qualità, revisione, latenza e utilizzo fatturato sugli stessi input. Cambiare contemporaneamente modello e livello rende più difficile individuare la causa delle differenze.
Cosa controllare passando da GPT-6 Sol?
Salva la configurazione funzionante e casi rappresentativi riusciti prima di cambiare modello, per poter tornare indietro. Questa è una procedura di verifica, non una migrazione testata per l'articolo.
- Abbina modello e impostazioni. Prima di impostare
modelsugpt-6.1-sol, verifica il livello di ragionamento. Per configurazioni precedenti connoneominimalnon supportati, la guida consiglia di partire dalowe confrontare compiti rappresentativi. - Controlla endpoint e strumenti. Usa Responses quando servono strumenti. Distingui richieste con e senza strumenti e verifica sia una risposta completata sia la continuazione dopo i risultati degli strumenti.
- Rimuovi parametri incompatibili. Con il ragionamento attivo, obbligatorio per questo modello, verifica
temperature,top_petop_logprobsnella guida. Controlla anchelogprobsin Chat Completions emessage.output_text.logprobsdentroincludein Responses. - Confronta completamento e utilizzo. Sullo stesso materiale registra accuratezza, formato, comportamento degli strumenti, stato finale e consumo di input, cache e output. Se non funziona, ripristina la configurazione salvata e isola il cambiamento prima di riprovare.
Per gli articoli, usa gli stessi documenti ufficiali e la stessa domanda, poi confronta affermazioni, numeri e condizioni con una procedura coerente di verifica dei fatti. Cambiare una variabile alla volta chiarisce il ruolo di modello, prompt, ragionamento e strumenti.
Chi dovrebbe valutare GPT-6.1 Sol?
Questi suggerimenti sono punti di partenza, non regole fisse o risultati di nostri test.
| Situazione | Candidato e motivo | Cosa verificare |
|---|---|---|
| Articoli complessi, analisi di documenti o codice con attenzione ai costi. | Valuta GPT-6.1 Sol per bilanciare capacità e prezzo. | Qualità, revisione necessaria e costo totale. |
| Classificazione o estrazione semplice ad alto volume. | Valuta Luna prima di pagare un modello più potente. | Eccezioni e input difficili, non soltanto esempi facili. |
| Prove contrastanti o errori costosi. | Confronta Astra e GPT-6.1 Sol sul lavoro effettivo. | Riscontro nelle fonti, gravità degli errori ed eventuale controllo professionale. |
| Un flusso GPT-6 Sol funziona già in modo affidabile. | Valuta GPT-6.1 Sol prima della migrazione. | Compatibilità, formati e regressioni nei casi prima riusciti. |
Fonte: guida OpenAI alla scelta del modello.
Per un blog, fornisci a ogni candidato la stessa scaletta e le stesse fonti. Controlla se la bozza risponde alla domanda promessa, contiene errori o affermazioni non supportate e richiede molta revisione. Lunghezza e tono sicuro non sostituiscono questi controlli.
Limiti e lista pratica di valutazione
GPT-6.1 Sol non sostituisce la verifica. Per informazioni attuali, controlla fonti originali, numeri e link. Quando un errore può causare danni seri, come nei consigli legali, finanziari o sanitari, resta importante una revisione professionale adeguata.
Valuta separatamente i permessi degli strumenti. Pubblicare, eliminare file, pagare e inviare messaggi può avere conseguenze difficili da annullare. Usa approvazioni, registri e condizioni di arresto chiare. Un modello più capace non giustifica automaticamente maggiori autorizzazioni.
- Prepara esempi rappresentativi. Includi casi facili e difficili, eliminando dati sensibili non necessari.
- Definisci l'accettazione. Stabilisci accuratezza, formato, prove richieste e tempi prima del confronto.
- Mantieni il confronto controllato. Usa input e strumenti uguali e registra errori e tentativi, non soltanto la risposta finale.
- Confronta il costo dei risultati accettabili. Tra i candidati che soddisfano i criteri, considera utilizzo API totale e tempo di correzione umana.
- Verifica le regressioni. Ripeti casi riusciti dopo un cambiamento di modello o impostazioni.
GPT-6.1 Sol merita una valutazione quando il lavoro complesso richiede capacità elevate senza la tariffa standard di Astra. Compiti più semplici possono adattarsi a un modello leggero; quelli molto difficili richiedono un confronto diretto. La decisione utile deriva dai tuoi risultati su qualità, tempo e costo complessivo.