GPT-6.1 Sol : usages, tarifs API et différences avec GPT-6 Sol
GPT-6.1 Sol est un modèle OpenAI conçu pour les tâches complexes de programmation, d’utilisation d’ordinateur et de travail documentaire, avec un compromis entre capacités et coût. OpenAI le présente comme proche d’Astra sur certaines évaluations, ce qui ne signifie pas qu’il lui est équivalent dans tous les cas. Pour choisir, il faut vérifier la qualité obtenue, le temps de correction et le coût total du travail terminé.
Classer des milliers de courtes fiches et préparer un article publiable à partir de plusieurs sources demandent des qualités différentes. Le nom du modèle ne suffit donc pas à décider : partez du résultat attendu et des erreurs que vous devez éviter.
Source : fiche officielle de GPT-6.1 Sol.
À quels travaux GPT-6.1 Sol peut-il servir ?
GPT-6.1 Sol vise les tâches qui nécessitent de comprendre un contexte pour produire un livrable exploitable. Le guide de sélection d’OpenAI cite notamment la préparation d’une présentation à partir de résultats financiers ou la création d’un site à partir d’un cahier des charges.
Les usages suivants sont des pistes d’évaluation, pas les résultats d’un banc d’essai réalisé pour cet article :
- Programmation : examiner des exigences et du code existant, proposer une modification et préparer sa vérification. Une correction proposée doit encore être exécutée et contrôlée dans l’environnement concerné.
- Analyse documentaire : relever les convergences et les différences entre plusieurs fichiers, puis rédiger une synthèse ou un tableau comparatif. Indiquez les sources autorisées et demandez de signaler les informations absentes plutôt que de les inventer.
- Utilisation d’outils en plusieurs étapes : rechercher des informations, consulter des fichiers et produire un résultat. Dans ce fonctionnement dit agentique, le modèle avance dans une tâche à l’aide d’outils ; les fonctions réellement disponibles dépendent de l’application et des permissions accordées.
Pour un blog, ces capacités peuvent aider à organiser les critères d’une comparaison ou à rapprocher plusieurs documentations officielles. Une phrase bien rédigée ne prouve toutefois pas son exactitude. Les vérifications de sources et les décisions éditoriales restent nécessaires.
Source : guide OpenAI de sélection des modèles.
Entrées, sorties et principales caractéristiques
Une interface de programmation, ou API, permet à un logiciel d’appeler directement le modèle. Les caractéristiques ci-dessous concernent ce modèle API ; elles ne décrivent pas les outils ou les plafonds de chaque abonnement qui peut y donner accès.
| Élément | GPT-6.1 Sol | Interprétation |
|---|---|---|
| Identifiant | gpt-6.1-sol | Valeur du modèle dans une requête API. |
| Entrées | Texte et images | Instructions écrites et images dans les formats pris en charge. |
| Sortie directe | Texte | La génération d’images par un outil constitue une fonction distincte. |
| Fenêtre de contexte | 1 050 000 jetons | Budget de contexte de la requête, qui doit laisser la place aux entrées et aux sorties. |
| Sortie maximale | 128 000 jetons | Le raisonnement généré est compris dans la sortie ; le résultat effectif dépend aussi des réglages et du contexte disponible. |
| Contexte restant si la sortie maximale est réservée | 922 000 jetons | Différence arithmétique entre les deux valeurs précédentes, et non plafond d’entrée indépendant annoncé dans la fiche. |
| Limite des connaissances intégrées | 30 avril 2026 | Les faits plus récents nécessitent des sources à jour ou des outils de recherche. |
| Audio et vidéo directs | Non pris en charge | Transcrire un enregistrement ou extraire des images d’une vidéo ne constitue pas une entrée audio ou vidéo native. |
Les jetons sont les unités utilisées pour traiter et facturer les entrées et les sorties. Ils ne correspondent pas à un nombre fixe de mots ou de caractères : leur quantité dépend de la langue et du contenu. Il serait donc trompeur de convertir la fenêtre de contexte en un nombre garanti de pages.
Une grande fenêtre ne garantit pas non plus que tous les détails seront correctement retrouvés. Écartez les fichiers inutiles, distinguez les documents à analyser des références complémentaires et demandez de situer les éléments de preuve importants. Un dossier très long augmente aussi le travail nécessaire pour vérifier la réponse.
Source : caractéristiques de GPT-6.1 Sol.
Tarifs API et exemples de calcul
L’entrée ordinaire, la lecture du cache, l’écriture du cache et la sortie ont des tarifs distincts. Répéter une consigne ne signifie pas que tous ses jetons bénéficieront du prix de lecture du cache : examinez les règles applicables et les usages effectivement enregistrés.
| Catégorie | Tarif Standard en USD par million de jetons |
|---|---|
| Entrée ordinaire | 2,00 |
| Lecture du cache | 0,10 |
| Écriture du cache, durée par défaut de 30 minutes | 2,50 |
| Écriture du cache, durée de 12 heures | 5,00 |
| Sortie | 10,00 |
Une lecture réutilise une entrée déjà mise en cache, tandis qu’une écriture la conserve pour un éventuel usage ultérieur. Pour GPT-6.1 Sol, le guide de mise en cache indique respectivement 5 % du tarif d’entrée ordinaire pour la lecture, 1,25 fois ce tarif pour une écriture de 30 minutes et 2,5 fois pour une écriture de 12 heures. Écrire un préfixe qui ne sera jamais réutilisé peut coûter davantage ; vérifiez donc quels éléments se répètent réellement.
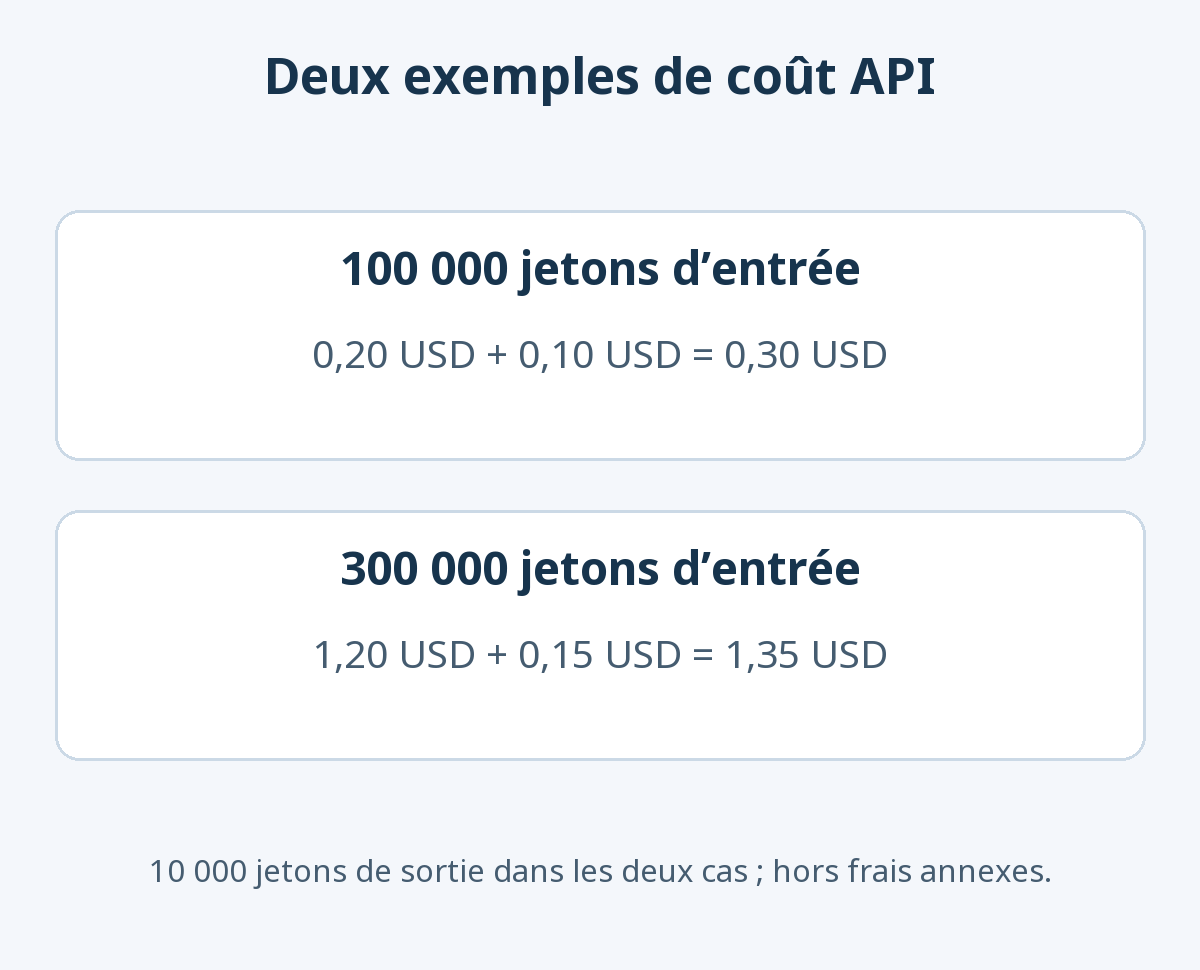
Avec 100 000 jetons d’entrée ordinaire et 10 000 jetons de sortie facturables au tarif Standard, l’entrée revient à 0,20 USD et la sortie à 0,10 USD, soit 0,30 USD au total. Cet exemple exclut le cache, les outils, les taxes et les majorations de traitement ou de région. Il ne constitue pas un prix fixe par article.
Les jetons de raisonnement sont facturés dans la sortie. Dans l’API Responses, output_tokens les comprend déjà ; output_tokens_details.reasoning_tokens en précise la part. Ajouter cette part une seconde fois doublerait son coût dans votre calcul. Utilisez les relevés d’usage plutôt que la longueur de la réponse visible. Un max_output_tokens trop faible peut également produire une réponse incomplete avant la fin du texte attendu : contrôlez le statut d’achèvement.
Sources : tarifs API OpenAI et guide du raisonnement.
Pour les entrées, séparez la part ordinaire, les lectures et les écritures de chaque durée. Le total usage.input_tokens inclut ces catégories : ne le facturez pas intégralement au tarif ordinaire avant d’ajouter encore le cache. Les champs cached_tokens et cache_write_tokens permettent d’isoler lectures et écritures ; ttl_30m_tokens et ttl_12h_tokens détaillent les écritures sans chevauchement. L’entrée ordinaire est le reste après retrait des lectures et écritures.
Le tarif des entrées longues concerne toute la requête
Au-delà de 272 000 jetons d’entrée, les tarifs d’entrée et de cache sont multipliés par deux et celui de sortie par 1,5. Ces facteurs concernent toute la requête, pas seulement la fraction qui dépasse le seuil.
Ainsi, 300 000 jetons d’entrée ordinaire coûtent 1,20 USD au tarif ajusté de 4 USD par million. Avec 10 000 jetons de sortie facturables à 15 USD par million, ajoutez 0,15 USD : le total atteint 1,35 USD, avant les autres frais éventuels.
Les deux exemples ci-dessous utilisent la même quantité de sortie. Les quantités d’entrée et les tarifs applicables diffèrent ; il s’agit d’une illustration arithmétique, pas d’un test de performance ni d’une facture réelle.
Découper un dossier peut diminuer le contexte d’une requête, mais aussi masquer les liens entre documents ou entraîner des répétitions et des coûts de synthèse supplémentaires. Organisez les fichiers selon les informations nécessaires à une réponse fiable, et non selon le seul seuil tarifaire.
Modes de traitement et abonnements répondent à des règles différentes
Fast coûte deux fois le tarif Standard et Ultrafast six fois. Batch et Flex proposent une réduction de 50 %, selon leur disponibilité et leurs conditions d’utilisation. Ce sont des rapports de prix, pas des multiplicateurs garantis de vitesse. Distinguez les réponses attendues immédiatement des travaux asynchrones pouvant être terminés plus tard.
La documentation d’octobre 2026 indique la prise en charge de la résidence des données aux États-Unis et dans l’Union européenne pour GPT-6.1 Sol, y compris avec Fast et Ultrafast. Le traitement régional comporte une majoration de 10 % lorsqu’il est disponible. Vérifiez la combinaison de région, de mode et de paramètres du compte au lieu de reprendre les restrictions d’un autre modèle.
Les prix des jetons API ne sont pas ceux des abonnements ChatGPT ou Codex. Les modèles, les outils et les limites accessibles dans une application dépendent de l’offre et du compte ; on ne peut pas déduire leur quota d’un tableau tarifaire API.
Source : tarifs, modes et résidence des données de GPT-6.1 Sol.
Comparaison avec GPT-6 Sol, Astra et Luna
Des noms proches ne signifient pas des capacités ou des réglages identiques. Ce tableau rapproche leur positionnement et leurs tarifs Standard, sans prétendre mesurer leurs performances.
| Modèle | Positionnement général | Entrée | Lecture du cache | Sortie |
|---|---|---|---|---|
| GPT-6.1 Sol | Équilibre entre capacités et coût pour les travaux complexes | 2,00 | 0,10 | 10,00 |
| GPT-6 Sol | Programmation complexe et tâches agentiques | 2,00 | 0,20 | 10,00 |
| GPT-6 Astra | Travaux les plus exigeants | 10,00 | 1,00 | 50,00 |
| GPT-6 Luna | Tâches ciblées en grand volume | 0,10 | 0,01 | 0,50 |
Les montants sont en USD par million de jetons, hors ajustements pour entrée longue, outils et autres majorations. Un jeton moins cher ne garantit pas un travail terminé moins cher : la consommation, les nouvelles tentatives et les corrections peuvent varier.
La lecture du cache de GPT-6.1 Sol coûte ici deux fois moins que celle de GPT-6 Sol. La facture complète ne diminue pas pour autant de moitié : le gain dépend de la part réellement lue dans le cache et du poids de la sortie et des autres frais.
Sources : comparateur OpenAI et fiche de GPT-6 Sol.
La comparaison de six modèles GPT-6 et GPT-5.6 par usage et coût API propose un cadre plus large. Associez ces critères aux caractéristiques et prix officiels en vigueur au moment de votre choix.
Vérifier le raisonnement et la compatibilité de l’API
L’effort de raisonnement indique le niveau d’effort demandé au modèle pour résoudre le problème. GPT-6.1 Sol accepte low, medium, high, xhigh et max, avec medium par défaut. Les valeurs none et minimal ne sont pas prises en charge.
GPT-6 Sol accepte none : migrer ne consiste donc pas nécessairement à modifier uniquement le nom du modèle. Revoyez aussi l’effort et les appels d’outils. Avec GPT-6.1 Sol, ces appels passent par Responses ; Chat Completions permet les échanges de texte sans cette prise en charge des outils.
Source : guide d’utilisation de la famille GPT-6.
Commencez avec le réglage par défaut sur des tâches représentatives, puis ajustez si les résultats le justifient. Comparez qualité, corrections, délai et usage facturable à entrées identiques. Modifier simultanément le modèle, les consignes et l’effort rend la cause des différences difficile à identifier.
Que contrôler lors d’une migration depuis GPT-6 Sol ?
Conservez la configuration fonctionnelle et quelques cas réussis avant de changer de modèle : ils servent de point de retour. La démarche suivante permet d’organiser la migration et sa vérification.
- Faire correspondre modèle et réglages. Avant de définir
modelsurgpt-6.1-sol, vérifiez l’effort existant. Le guide de migration recommande de commencer parlowlorsqu’on remplace un réglagenoneouminimalnon accepté, puis d’évaluer des tâches représentatives. - Contrôler l’API et les outils. Utilisez Responses si la tâche nécessite des outils. Séparez les cas avec et sans outil, et vérifiez à la fois une réponse complète et la poursuite du travail après le retour d’un outil.
- Retirer les paramètres incompatibles. Le raisonnement étant obligatoire ici, retirez les paramètres non pris en charge indiqués dans le guide :
temperature,top_pettop_logprobs. Dans Chat Completions, cela concerne égalementlogprobs; dans Responses, retirezmessage.output_text.logprobsdeinclude. - Comparer achèvement et usage. Avec les mêmes documents, relevez exactitude, format, comportement des outils, statut final et volumes d’entrée, de cache et de sortie. En cas d’échec, restaurez la configuration conservée et isolez la modification avant de réessayer.
Pour un article, donnez aux deux configurations les mêmes documents officiels et la même question, puis appliquez une méthode constante de vérification des faits. Comparez aussi les conditions et les exceptions omises, pas seulement les phrases manifestement fausses.
Dans quels cas envisager GPT-6.1 Sol ?
Ces propositions servent de points de départ à une évaluation. Elles ne remplacent pas des résultats obtenus sur votre propre travail.
| Situation | Candidat et raison | Points à contrôler |
|---|---|---|
| Articles complexes, analyse ou code avec contrainte de coût | Évaluer GPT-6.1 Sol pour son équilibre entre capacités et prix. | Qualité, corrections nécessaires et coût total d’achèvement. |
| Classement ou extraction simple en grand volume | Évaluer d’abord Luna. | Exceptions et entrées difficiles, en plus des exemples faciles. |
| Sources contradictoires ou erreurs coûteuses | Comparer Astra et GPT-6.1 Sol sur le travail concerné. | Solidité des preuves, gravité des erreurs et contrôle professionnel nécessaire. |
| Processus GPT-6 Sol déjà fiable | Tester GPT-6.1 Sol avant de migrer. | Compatibilité, formats et régressions sur les cas déjà réussis. |
Source : guide de sélection OpenAI.
Dans un travail éditorial, fournissez les mêmes sources et le même plan aux candidats. Vérifiez si chaque texte répond à la question promise, ajoute des affirmations sans preuve ou nécessite une reprise importante. La longueur et l’assurance du ton ne remplacent pas cette lecture.
Limites et méthode d’évaluation pratique
GPT-6.1 Sol ne remplace pas la vérification. Pour des informations actuelles, consultez les sources originales et contrôlez les chiffres et les liens. Lorsque l’erreur pourrait avoir des conséquences graves, notamment en santé, en droit ou en finance, prévoyez l’examen professionnel adapté.
Les permissions des outils demandent un examen distinct. Publier, supprimer un fichier, payer ou envoyer un message peut avoir des conséquences difficiles à annuler. Prévoyez des validations adaptées, un historique et des conditions d’arrêt claires. Les capacités du modèle ne justifient pas à elles seules des permissions plus larges.
- Préparer des exemples représentatifs. Incluez des cas simples et difficiles, en retirant les informations sensibles inutiles.
- Définir les critères d’acceptation. Fixez l’exactitude attendue, le format, les preuves nécessaires et le délai acceptable avant d’examiner les résultats.
- Garder des conditions comparables. Utilisez les mêmes entrées et outils. Notez les erreurs et les tentatives nécessaires, au lieu de ne conserver que la dernière réponse.
- Comparer le coût d’un résultat acceptable. Parmi les candidats satisfaisant vos critères, rapprochez usage API total et temps de correction humaine.
- Rechercher les régressions. Rejouez des cas précédemment réussis après chaque changement important de modèle ou de réglage.
GPT-6.1 Sol mérite ainsi une évaluation pour les travaux complexes où le tarif Standard d’Astra est difficile à justifier. Une tâche plus simple peut convenir à un modèle léger ; une tâche particulièrement exigeante peut nécessiter une comparaison directe. La décision utile repose sur la qualité, le temps et le coût observés dans votre propre contexte.