Apa Itu GPT-6.1 Sol? Fitur, Harga API, dan Perbedaannya dengan GPT-6 Sol
GPT-6.1 Sol adalah model bahasa OpenAI yang menyeimbangkan kemampuan dan biaya untuk pemrograman kompleks, penggunaan komputer, serta pekerjaan profesional. OpenAI menyebut kinerjanya mendekati Astra dengan harga lebih rendah, tetapi itu tidak berarti setara pada setiap tugas. Pertanyaan praktisnya adalah apakah model memenuhi standar kualitas Anda dengan waktu revisi dan biaya total yang dapat diterima.
Pilih berdasarkan pekerjaan, bukan nama saja. Mengklasifikasikan ribuan entri pendek dan menyusun artikel layak terbit dari beberapa sumber membutuhkan ketelitian, penalaran, dan pemeriksaan yang berbeda.
Sumber: dokumentasi resmi model GPT-6.1 Sol.
Untuk apa GPT-6.1 Sol berguna?
GPT-6.1 Sol ditujukan bagi pekerjaan yang memerlukan pemahaman konteks dan hasil berguna, bukan sekadar teks lancar. Panduan pemilihan model OpenAI mencontohkan penyusunan presentasi dewan dari laporan keuangan atau pembuatan situs dari ringkasan kebutuhan produk.
Berikut kemungkinan penggunaan, bukan hasil tolok ukur kami atau jaminan selalu lebih unggul:
- Pemrograman: memahami kebutuhan, memeriksa kode, mengusulkan perubahan, dan menyiapkan pengujian. Perbaikan usulan tetap perlu dijalankan serta diverifikasi di lingkungan terkait.
- Analisis dokumen: menemukan kesamaan dan perbedaan antardokumen, lalu menyusun laporan atau perbandingan. Tetapkan sumber yang diizinkan dan larang penambahan tanpa dukungan.
- Penggunaan alat bertahap: mencari informasi, memeriksa berkas, lalu menghasilkan keluaran melalui beberapa langkah. Ini sering disebut alur kerja berbasis agen: model bekerja dengan alat. Tindakan yang mungkin dilakukan ditentukan oleh alat dan izin yang disediakan aplikasi.
Bagi blogger, kemampuan tersebut dapat membantu menyusun kriteria perbandingan atau menggabungkan dokumentasi resmi. Namun, paragraf rapi tidak membuktikan klaimnya benar. Pemeriksaan sumber dan pertimbangan editorial tetap diperlukan.
Sumber: panduan pemilihan model OpenAI.
Input, output, dan spesifikasi utama
Antarmuka pemrograman aplikasi (API) memungkinkan perangkat lunak memanggil model langsung. Spesifikasi berikut berlaku untuk model API, bukan fitur langganan atau batas penggunaan semua aplikasi yang menyediakannya.
| Aspek | GPT-6.1 Sol | Artinya |
|---|---|---|
| ID model | gpt-6.1-sol | Pengenal dalam permintaan API. |
| Input | Teks dan gambar | Permintaan dapat menyertakan instruksi tertulis dan masukan gambar yang didukung. |
| Output | Teks | Pembuatan gambar melalui alat berbeda dari jenis keluaran langsung model. |
| Jendela konteks | 1.050.000 token | Ruang konteks permintaan, termasuk masukan dan keluaran yang relevan. |
| Sisa ruang jika output maksimum dicadangkan | 922.000 token | Hasil pengurangan konteks dengan batas output, bukan batas input tetap yang dinyatakan terpisah dalam dokumentasi resmi yang diperiksa. |
| Output maksimum | 128.000 token | Termasuk penalaran yang dihasilkan; jumlah aktual bergantung pada pengaturan dan ruang konteks. |
| Batas pengetahuan | 30 April 2026 | Fakta lebih baru membutuhkan sumber terbaru atau alat pencarian. |
| Audio dan video langsung | Tidak didukung | Alur yang mentranskripsikan audio atau mengambil bingkai video berbeda dari dukungan input audio atau video bawaan. |
Angka sisa ruang di atas adalah contoh perhitungan jika seluruh output maksimum dicadangkan, bukan batas input resmi tambahan yang terverifikasi. Token merupakan unit pemrosesan dan penagihan input maupun output; nilainya tidak setara dengan jumlah kata atau karakter tetap. Pemakaiannya berbeda menurut bahasa dan isi, sehingga jendela konteks tidak dapat dijanjikan sebagai jumlah halaman tertentu.
Konteks besar juga tidak menjamin setiap detail ditemukan sempurna. Singkirkan berkas tidak relevan, bedakan bahan analisis dari referensi pendukung, dan minta lokasi bukti penting. Input panjang memengaruhi biaya serta kesulitan memeriksa jawaban.
Sumber: spesifikasi GPT-6.1 Sol.
Harga API dan contoh perhitungan
Input biasa, pembacaan input dari cache, penulisan cache, dan output memiliki harga terpisah. Mengulang prompt tidak otomatis membuat seluruh input memenuhi tarif cache. Periksa perilaku penyimpanan serta penggunaan aktual.
| Kategori tagihan | Harga Standard per 1 juta token, USD |
|---|---|
| Input | US$2,00 |
| Input dari cache | US$0,10 |
| Tulis cache: bawaan 30 menit | US$2,50 |
| Tulis cache: 12 jam | US$5,00 |
| Output | US$10,00 |
Pembacaan cache menggunakan ulang input tersimpan; penulisan menyimpan input agar dapat digunakan kembali. Panduan cache resmi menetapkan tarif baca GPT-6.1 Sol sebesar 5% dari input biasa, penulisan bawaan 30 menit sebesar 1,25 kali input biasa, serta pilihan 12 jam sebesar 2,5 kali. Awalan konteks yang ditulis tetapi tidak pernah dipakai ulang dapat lebih mahal. Nilai apakah konteks memang berulang.
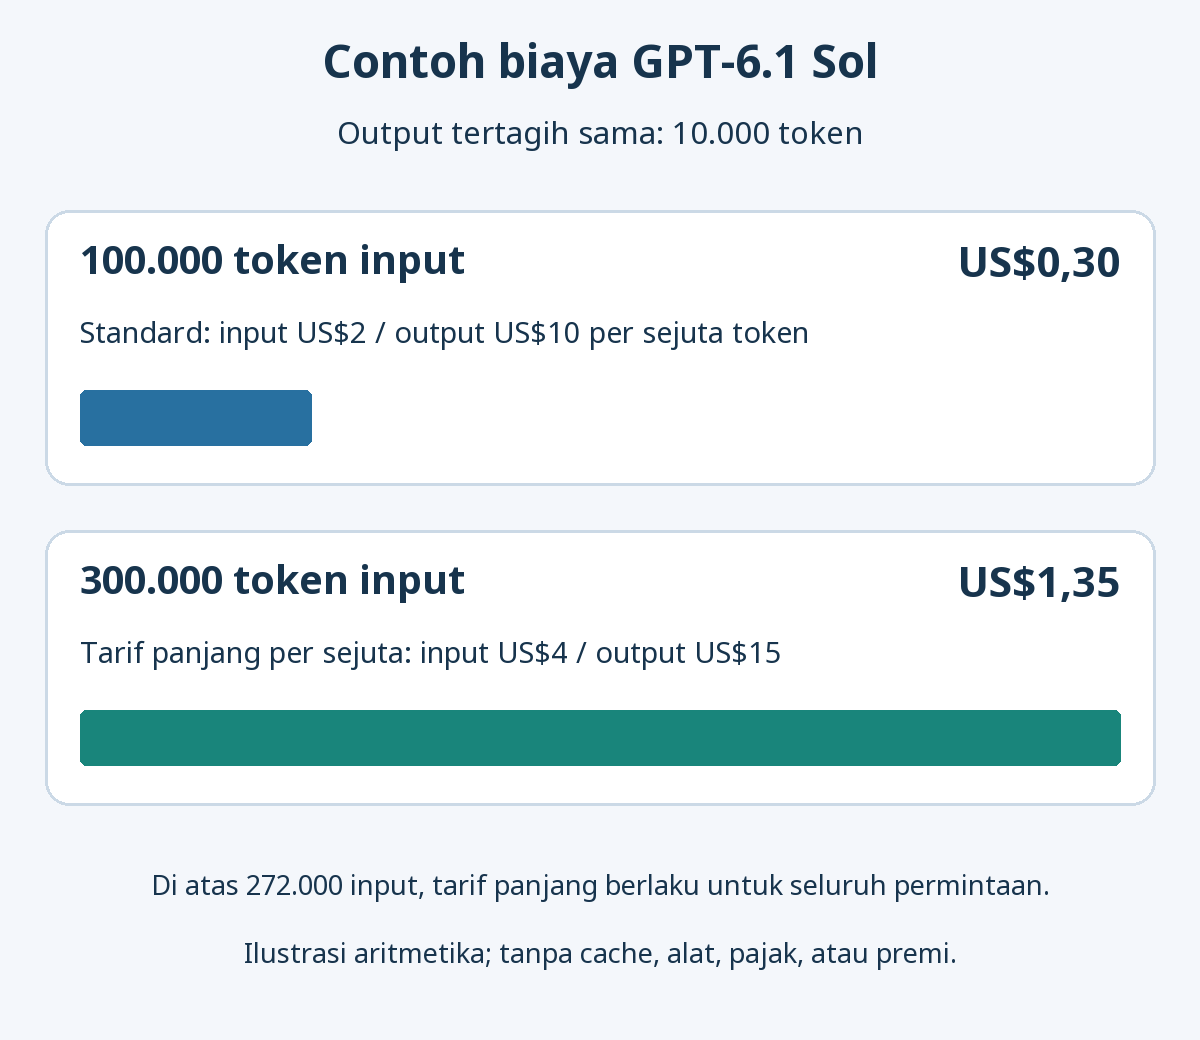
Untuk permintaan standar dengan 100.000 token input biasa dan 10.000 token output tertagih, biayanya US$0,20 ditambah US$0,10, yaitu US$0,30. Contoh ini tidak mencakup biaya cache, alat, pajak, atau premi pemrosesan dan wilayah. Ini bukan harga tetap per artikel.
Token penalaran ditagih sebagai output. Pada penggunaan Responses API, output_tokens sudah mencakup penalaran; output_tokens_details.reasoning_tokens menunjukkan bagiannya. Menambahkannya lagi akan menghitung ganda. Gunakan catatan penggunaan, bukan panjang jawaban terlihat. Batas max_output_tokens terlalu kecil dapat menghasilkan status incomplete sebelum jawaban terlihat selesai. Periksa penyelesaian dan biaya; percobaan ulang, pencarian, revisi, serta pemeriksaan manusia juga memengaruhi total biaya tugas.
Sumber: harga OpenAI API dan panduan penalaran OpenAI.
Perhitungan input juga harus membedakan input biasa, pembacaan cache, penulisan 30 menit, dan penulisan 12 jam. Menghitung semua usage.input_tokens dengan tarif biasa lalu menambahkan cache akan menghitung ganda. Bidang penggunaan resmi memisahkan cached_tokens, cache_write_tokens, dan rincian masa penyimpanan; input biasa adalah sisa total setelah pembacaan serta penulisan dikeluarkan.
Tarif input panjang berlaku untuk seluruh permintaan
Jika input melebihi 272.000 token, tarif input dan cache menjadi dua kali Standard, sedangkan output menjadi 1,5 kali. Pengali berlaku untuk seluruh permintaan, bukan hanya token di atas ambang.
Contohnya, 300.000 token input biasa berbiaya US$1,20 dengan tarif US$4 per sejuta. Tambahan 10.000 token output tertagih berbiaya US$0,15 pada tarif US$15 per sejuta. Totalnya US$1,35 sebelum biaya lain yang berlaku.
Grafik membandingkan contoh 100.000 input dengan 300.000 input. Keduanya menghasilkan 10.000 token output tertagih, tetapi jumlah input dan tarifnya berbeda. Ini ilustrasi aritmetika, bukan uji kinerja atau tagihan aktual.
Memisahkan dokumen dapat mengurangi konteks per permintaan, tetapi juga menyembunyikan hubungan antardokumen atau menambah pengulangan input dan biaya pembuatan ringkasan. Susun bahan berdasarkan konteks yang diperlukan untuk jawaban andal, bukan hanya ambang tarif.
Mode pemrosesan berbeda dari langganan aplikasi
Harga Fast dua kali Standard, Ultrafast enam kali, sedangkan Batch dan Flex 50% lebih rendah, sesuai ketersediaan dan ketentuan operasinya. Itu pengali harga, bukan jaminan pengali kecepatan. Pertimbangkan latensi dan jadwal: tugas yang perlu jawaban segera berbeda dari pekerjaan asinkron yang bisa selesai kemudian.
Panduan resmi pada Oktober 2026 menyebut dukungan residensi data Uni Eropa untuk Fast serta Amerika Serikat dan Uni Eropa untuk Ultrafast pada GPT-6.1 Sol. Residensi data mengatur wilayah pemrosesan atau penyimpanan sesuai fitur dan kelayakan layanan. Pemrosesan regional menambah premi 10% jika tersedia. Periksa kombinasi wilayah, mode, serta pengaturan akun; jangan menerapkan batas wilayah model lain secara otomatis.
Harga token API berbeda dari harga langganan ChatGPT atau Codex. Model, alat, dan batas penggunaan aplikasi bergantung pada akun serta paket. Harga API tidak menunjukkan jatah langganan.
Sumber: harga dan mode pemrosesan GPT-6.1 Sol serta panduan model terbaru untuk kompatibilitas wilayah.
Apa bedanya dengan GPT-6 Sol, Astra, dan Luna?
Nama mirip tidak berarti kemampuan, pengaturan, atau harga sama. Tabel membandingkan posisi penggunaan dan tarif API Standard, bukan hasil tolok ukur kinerja.
| Model | Posisi penggunaan | Input | Cache | Output |
|---|---|---|---|---|
| GPT-6.1 Sol | Keseimbangan kemampuan dan biaya untuk pekerjaan kompleks. | US$2,00 | US$0,10 | US$10,00 |
| GPT-6 Sol | Pemrograman kompleks dan alur berbasis agen. | US$2,00 | US$0,20 | US$10,00 |
| GPT-6 Astra | Pekerjaan paling menuntut. | US$10,00 | US$1,00 | US$50,00 |
| GPT-6 Luna | Tugas terarah dengan volume tinggi. | US$0,10 | US$0,01 | US$0,50 |
Harga dalam dolar AS per 1 juta token pada Standard, tidak termasuk pengali input panjang, alat, dan penyesuaian lain. Harga token lebih rendah belum tentu membuat biaya tugas selesai lebih rendah; kebutuhan token, pengulangan, dan koreksi dapat berbeda.
Dalam perbandingan ini, harga input cache GPT-6.1 Sol setengah GPT-6 Sol, bukan berarti seluruh tagihan menjadi setengah. Manfaat bergantung pada porsi input yang memperoleh tarif cache dan porsi biaya output serta biaya lain.
Sumber: perbandingan model OpenAI dan dokumentasi GPT-6 Sol.
Untuk perbandingan lebih luas dengan keluarga GPT-5.6, baca enam model GPT-6 dan GPT-5.6 menurut penggunaan serta biaya API. Gunakan kriterianya bersama spesifikasi dan harga resmi terbaru.
Perhatikan pengaturan penalaran dan kompatibilitas API
Upaya penalaran mengatur seberapa besar usaha model untuk mengerjakan masalah. GPT-6.1 Sol mendukung low, medium, high, xhigh, dan max, dengan medium sebagai bawaan. Model tidak mendukung none atau minimal.
GPT-6 Sol mendukung none, sehingga migrasi tidak cukup dengan mengganti nama model. Periksa pengaturan penalaran dan kompatibilitas pemanggilan alat. GPT-6.1 Sol mendukung alat melalui Responses API; penggunaan alat tidak didukung melalui Chat Completions.
Sumber: panduan model terbaru OpenAI.
Mulai dari bawaan pada tugas representatif, lalu sesuaikan jika hasil membenarkannya. Bandingkan kualitas, revisi, latensi, dan penggunaan tertagih dengan input sama. Mengubah model sekaligus pengaturan membuat penyebab perbedaan lebih sulit dikenali.
Apa yang diperiksa ketika beralih dari GPT-6 Sol?
Simpan konfigurasi yang berfungsi dan contoh kasus berhasil sebelum mengganti model agar ada titik pemulihan. Langkah berikut adalah proses peninjauan, bukan klaim bahwa migrasi sudah diuji untuk artikel ini.
- Cocokkan model dan pengaturan. Sebelum mengganti
modelmenjadigpt-6.1-sol, periksa dukungan upaya penalaran. Untuk konfigurasi lama dengannoneatauminimalyang tidak didukung model tujuan, panduan migrasi menyarankan mulai darilow, lalu mengevaluasi tugas representatif. - Periksa endpoint dan alat. Gunakan Responses ketika alat diperlukan. Pisahkan permintaan dengan dan tanpa alat, lalu verifikasi respons selesai serta kelanjutan setelah hasil alat diterima.
- Hapus parameter yang tidak didukung. Saat penalaran aktif, yang diwajibkan model ini, periksa
temperature,top_p, dantop_logprobsterhadap panduan. Periksa pulalogprobspada Chat Completions danmessage.output_text.logprobsdalamincludeResponses. - Bandingkan penyelesaian dan penggunaan. Dengan bahan sama, catat akurasi, format, perilaku alat, status penyelesaian, serta penggunaan input, cache, dan output. Jika gagal, pulihkan konfigurasi tersimpan dan pisahkan perubahan sebelum mencoba lagi.
Untuk pekerjaan artikel, berikan dokumen resmi dan pertanyaan sama, lalu bandingkan klaim, angka, dan kondisi dengan proses pemeriksaan fakta yang konsisten. Satu perubahan setiap kali membantu mengenali apakah perbedaan berasal dari model, prompt, upaya penalaran, atau alat.
Siapa yang sebaiknya mengevaluasi GPT-6.1 Sol?
Saran berikut adalah titik awal evaluasi, bukan aturan tetap atau hasil pengujian kami.
| Situasi | Kandidat dan alasan | Yang diperiksa |
|---|---|---|
| Artikel kompleks, analisis dokumen, atau pemrograman dengan pertimbangan biaya. | Evaluasi GPT-6.1 Sol untuk keseimbangan kemampuan dan harga. | Kualitas, kebutuhan revisi, dan total biaya penyelesaian. |
| Klasifikasi atau ekstraksi sederhana dengan volume tinggi. | Evaluasi Luna sebelum membayar model lebih kuat. | Pengecualian serta input sulit, bukan hanya contoh mudah. |
| Bukti bertentangan atau kesalahan berbiaya besar. | Bandingkan Astra dan GPT-6.1 Sol pada pekerjaan sebenarnya. | Dukungan sumber, dampak kesalahan, dan kebutuhan peninjauan profesional. |
| Alur GPT-6 Sol sudah bekerja andal. | Evaluasi GPT-6.1 Sol sebelum migrasi. | Kompatibilitas, format output, dan kemunduran pada tugas yang sebelumnya berhasil. |
Sumber: panduan pemilihan model OpenAI.
Untuk alur blog, berikan kerangka dan bahan sumber sama kepada kandidat. Periksa apakah draf menjawab pertanyaan yang dijanjikan, mengandung kesalahan atau klaim tanpa bukti, dan memerlukan banyak penyuntingan. Panjang serta nada yakin tidak menggantikan pemeriksaan ini.
Keterbatasan dan daftar periksa evaluasi
GPT-6.1 Sol tidak menggantikan verifikasi. Untuk informasi terkini, periksa sumber asli, angka, dan tautan. Jika kesalahan dapat menimbulkan kerugian serius, misalnya pada nasihat hukum, keuangan, atau kesehatan, peninjauan ahli yang sesuai tetap penting.
Periksa izin alat secara terpisah. Menerbitkan konten, menghapus berkas, membayar, dan mengirim pesan dapat sulit dibatalkan. Gunakan persetujuan, catatan tindakan, dan kondisi berhenti yang jelas. Model lebih mampu tidak otomatis membenarkan izin lebih luas.
- Siapkan contoh representatif. Sertakan kasus mudah dan sulit, serta hapus informasi sensitif yang tidak diperlukan.
- Tentukan kriteria penerimaan. Tetapkan akurasi, format, bukti, dan waktu penyelesaian sebelum membandingkan.
- Kendalikan perbandingan. Gunakan input serta alat sama, dan catat kesalahan maupun percobaan ulang, bukan hanya jawaban final.
- Bandingkan biaya hasil yang memenuhi kriteria. Di antara kandidat yang lolos, hitung pemakaian API total serta waktu koreksi manusia.
- Periksa kemunduran. Jalankan ulang kasus yang sebelumnya berhasil setelah model atau pengaturannya berubah.
GPT-6.1 Sol layak dievaluasi ketika pekerjaan kompleks membutuhkan kemampuan kuat dengan harga token standar di bawah Astra. Tugas lebih sederhana mungkin sesuai dengan model ringan, sedangkan pekerjaan sangat sulit memerlukan perbandingan langsung. Keputusan yang berguna didukung hasil Anda sendiri tentang kualitas, waktu, dan biaya total.