Was ist GPT-6.1 Sol? Funktionen, API-Preise und Unterschiede zu GPT-6 Sol
GPT-6.1 Sol ist ein OpenAI-Sprachmodell, das entwickelt wurde, um Fähigkeiten und Kosten für komplexe Codierung, Computernutzung und professionelle Arbeit auszugleichen. OpenAI beschreibt es als eine Leistung nahe der von Astra zu einem niedrigeren Preis, aber das bedeutet nicht, dass es bei jeder Aufgabe die Leistung von Astra erreicht. Die praktische Frage ist, ob es Ihre Qualitätsanforderungen mit vertretbarem Überarbeitungsaufwand und Gesamtkosten erfüllen kann.
Wählen Sie ein Modell nach der Arbeit, die es tun muss, nicht einfach nach seinem Namen. Die Klassifizierung von Tausenden von kurzen Einträgen und die Erstellung eines veröffentlichbaren Artikels aus verschiedenen Quellen beinhalten unterschiedliche Anforderungen an Genauigkeit, Schlussfolgern und Überprüfung.
Quelle: OpenAIs GPT-6.1 Sol Modelldokumentation.
Wofür ist GPT-6.1 Sol nützlich?
GPT-6.1 Sol ist für Arbeiten gedacht, die das Verständnis des Kontexts und die Erstellung eines nützlichen Ergebnisses erfordern, anstatt nur fließenden Text zu erzeugen. Die Richtlinien für die Modellauswahl von OpenAI umfassen Beispiele wie die Erstellung einer Vorstandspräsentation aus Finanzergebnissen oder den Aufbau einer Website aus einem Produktbrief.
Folgende sind mögliche Anwendungen, nicht Ergebnisse aus unserem eigenen Benchmark oder der Behauptung, dass dieses Modell immer Alternativen übertrifft:
- Coding: Anforderungen interpretieren, vorhandenen Code untersuchen, Änderungen vorschlagen und Tests vorbereiten. Vorgeschlagene Korrekturen müssen noch in der relevanten Umgebung ausgeführt und verifiziert werden.
- Dokumentanalyse: Identifizieren Sie allgemeine Ergebnisse und Unterschiede zwischen Dateien und erstellen Sie dann einen Bericht oder Vergleich. Geben Sie an, welche Quellen zulässig sind, und verbieten Sie nicht unterstützte Ergänzungen.
- Mehrstufige Tool-Nutzung: suche nach Informationen, inspiziere Dateien und produziere eine Ausgabe in mehreren Schritten. Dies wird oft als agentischer Workflow bezeichnet: Das Modell arbeitet mithilfe von Tools durch eine Aufgabe. Die von der Anwendung bereitgestellten Tools und Berechtigungen bestimmen, welche Aktionen tatsächlich möglich sind.
Für Blogger können diese Fähigkeiten helfen, Vergleichskriterien zu organisieren oder offizielle Dokumentation zu synthetisieren. Ein polierter Absatz ist jedoch kein Beweis dafür, dass seine Behauptungen korrekt sind. Quellenprüfungen und redaktionelles Urteil bleiben notwendig.
Quelle: OpenAIs Leitfaden zur Modellauswahl.
Eingaben, Ausgaben und wichtige Spezifikationen
Eine Application Programming Interface (API) ermöglicht es der Software, ein Modell direkt aufzurufen. Die folgenden Spezifikationen beschreiben das API-Modell, nicht die Abonnementfunktionen oder Nutzungsgrenzen jeder Anwendung, die es anbieten könnte.
| Position | GPT-6.1 Sol | Was es bedeutet |
|---|---|---|
| Modell-ID | gpt-6.1-sol | Der Identifikator, der in API-Anfragen verwendet wird. |
| Input | Text und Bilder | Anfragen können schriftliche Anweisungen und unterstützte Bildeingaben enthalten. |
| Output | Text | Die Bilderzeugung durch Tools ist von der direkten Ausgabemodalität des Modells getrennt. |
| Kontextfenster | 1.050.000 Token | Der maximale Kontext, der einer Anforderung zur Verfügung steht, einschließlich ihrer relevanten Inputs und Outputs. |
| Rechnerisches Eingabebudget bei maximal reservierter Ausgabe | 922.000 Token | 1.050.000 Token Kontext minus 128.000 Token für die maximale Ausgabe. Dies ist eine Rechengröße; beachten Sie zusätzlich die tatsächlichen Eingabegrenzen der API. |
| Maximale Ausgabe | 128.000 Token | Enthält auch die beim Schlussfolgern erzeugten Token; die tatsächliche Ausgabe hängt von den Anforderungseinstellungen und dem verfügbaren Kontext ab. |
| Wissensstand | 30. April 2026 | Neuere Fakten erfordern aktuelle Quellen oder Retrieval-Tools. |
| Direkte Audio- und Videounterstützung | Nicht unterstützt | Eine Pipeline, die Audio transkribiert oder Videoframes extrahiert, ist nicht dasselbe wie native Audio- oder Videoeingaben. |
Tokens sind die Einheiten, die verwendet werden, um Modell-Input und -Output zu verarbeiten und zu verrechnen. Sie sind keine feste Anzahl von Wörtern oder Zeichen: Der Tokenverbrauch variiert je nach Sprache und Inhalt. Folglich sollte ein Kontextfenster nicht in eine garantierte Anzahl von Seiten umgewandelt werden.
Ein großes Kontextfenster garantiert auch nicht das perfekte Abrufen jedes Details. Entfernen Sie irrelevante Dateien, unterscheiden Sie das zu analysierende Material von unterstützenden Referenzen und bitten Sie das Modell, herauszufinden, wo wichtige Beweise erscheinen. Lange Eingaben können sowohl die Kosten als auch die Schwierigkeit der Überprüfung der Antwort beeinflussen.
Quelle: Spezifikationen von GPT-6.1 Sol.
API-Preise und Beispielrechnungen
Input, Cached Input, Cache Writes und Output haben getrennte Preise. Gehen Sie nicht davon aus, dass das Wiederholen einer Eingabeaufforderung alle Eingaben für die Cache-Input-Rate geeignet macht. Überprüfen Sie das anwendbare Caching-Verhalten und die tatsächlichen Nutzungsaufzeichnungen.
| Abrechnungskategorie | Standardpreis pro 1 Million Token, USD |
|---|---|
| Input | $2.00 |
| Cache-Lesezugriffe | $0.10 |
| Cache-Schreiben: Standard 30 Minuten | $2.50 |
| Cache schreiben: 12 Stunden | $5.00 |
| Output | $10.00 |
Ein Cache-Read verwendet gespeicherte Eingaben wieder; ein Cache-Schreiben speichert Eingaben für eine mögliche Wiederverwendung. Der offizielle Caching-Leitfaden spezifiziert eine GPT-6.1 Sol Leserate von 5% der gewöhnlichen Eingabe, eine standardmäßige 30-Minuten Schreibrate von 1,25 mal der gewöhnlichen Eingabe und eine optionale 12-Stunden Schreibrate von 2,5 mal der gewöhnlichen Eingabe. Ein Präfix, das geschrieben, aber nie wiederverwendet wird, kann mehr kosten, also bewerten Sie, ob sich der Kontext tatsächlich wiederholt.
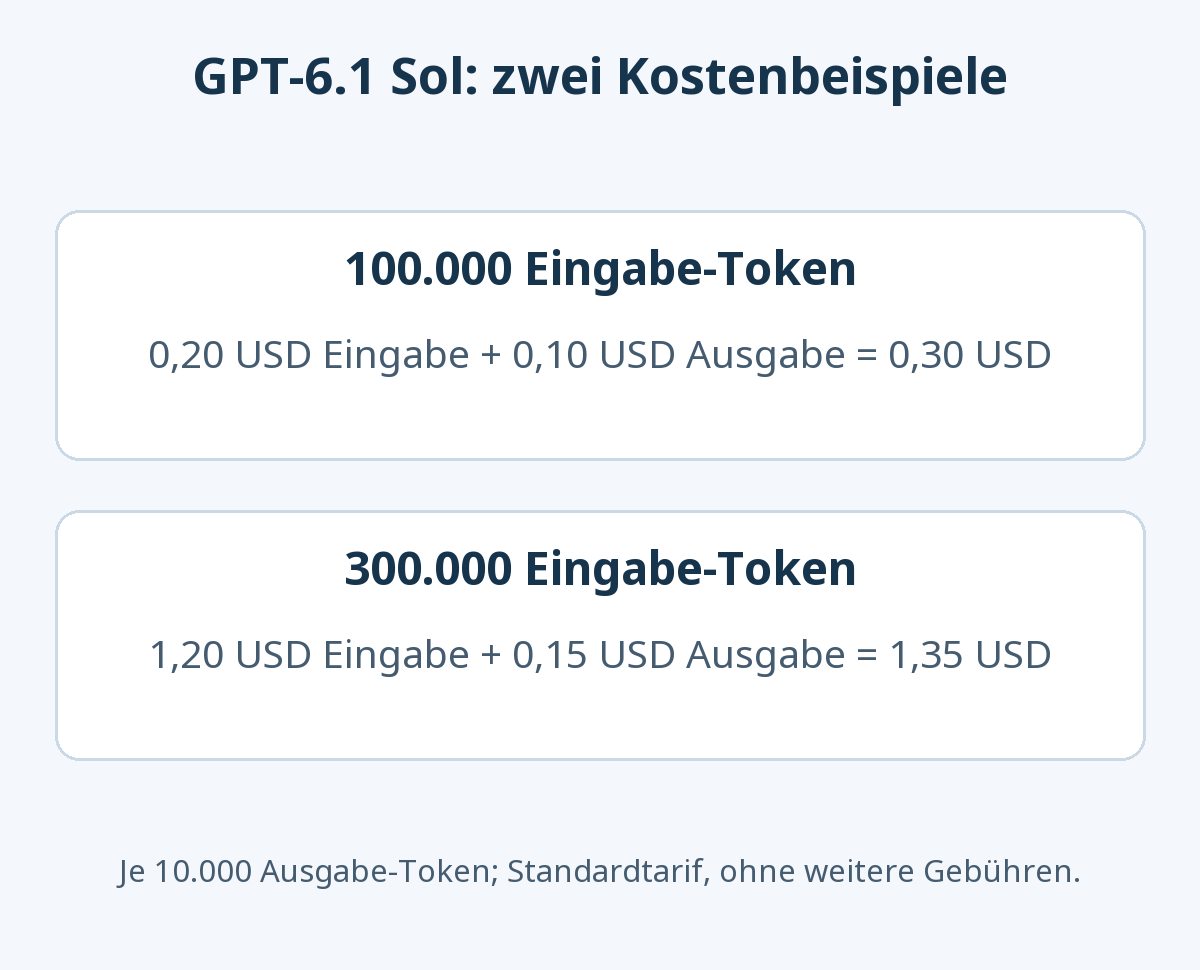
Für eine Standardanforderung mit 100.000 gewöhnlichen Input-Tokens und 10.000 abrechenbaren Output-Tokens beträgt die Berechnung $0,20 für Input plus $0,10 für Output oder $0,30 insgesamt. Dieses Beispiel schließt Caching-Gebühren, Tool-Gebühren, Steuern und Verarbeitungs- oder Regionalprämien aus. Es handelt sich nicht um Fixkosten pro Artikel.
Reasoning-Token werden als Output abgerechnet. In der Responses-API-Nutzung enthält output_tokens bereits die Reasoning-Token, während output_tokens_details.reasoning_tokens die beim Schlussfolgern verbrauchten Token meldet. Wenn man diesen Teil wieder hinzufügt, wird er doppelt gezählt. Verwenden Sie die gemeldete Nutzung anstelle der sichtbaren Antwortlänge. Ein max_output_tokens-Limit, das zu klein ist, kann eine incomplete-Antwort erzeugen, bevor die sichtbare Antwort beendet ist, also überprüfen Sie den Abschlussstatus sowie die Kosten. Retries, Suchen, Revisionen und menschliche Überprüfungen sind auch wichtig, wenn man die Gesamtkosten für die Ausführung einer Aufgabe vergleicht.
Quellen: OpenAI-API-Preise und OpenAIs Leitfaden zu Reasoning.
Die Eingabeabrechnung erfordert auch die Trennung von gewöhnlichen Eingaben, Cache-Reads, 30-Minuten-Schreiben und 12-Stunden-Schreiben. Wenn Sie alle usage.input_tokens als gewöhnliche Eingabe berechnen und Cache-Gebühren hinzufügen, werden Token doppelt gezählt. Die offiziellen Nutzungsfelder identifizieren cached_tokens, cache_write_tokens und die Schreibuntergliederung nach Lebensdauer; gewöhnliche Eingabe ist der Rest, nachdem Lese- und Schreibvorgänge von der Gesamteingabe entfernt wurden.
Long-Input-Preise gelten für die gesamte Anfrage
Wenn der Input 272.000 Token überschreitet, werden die Input- und Cache-Raten doppelt so hoch wie die Standardraten, während der Output das 1,5-fache des Standardsatzes beträgt. Diese Multiplikatoren gelten für die gesamte Anforderung, nicht nur für die Token über dem Schwellenwert.
Zum Beispiel kosten 300.000 gewöhnliche Input-Token 1,20 US-Dollar bei der angepassten Rate von 4 US-Dollar pro Million. Weitere 10.000 abrechenbare Output-Token kosten 0,15 US-Dollar zu 15 US-Dollar pro Million, was insgesamt 1,35 US-Dollar vor anderen anwendbaren Gebühren ergibt.
Das Diagramm vergleicht das Beispiel mit 100.000 Eingaben mit dem Beispiel mit 300.000 Eingaben. Beide haben 10.000 abrechenbare Output-Token, aber die Eingangsmengen und anwendbaren Sätze unterscheiden sich. Es ist eine arithmetische Illustration, kein Leistungstest oder eine tatsächliche Rechnung.
Das Teilen von Dokumenten kann die Menge an Kontext in einer Anfrage reduzieren, aber es kann auch Beziehungen zwischen Dokumenten verbergen oder wiederholte Eingaben und Kosten für die Erstellung von Zusammenfassungen einführen. Entscheiden Sie, wie Sie das Material basierend auf dem Kontext organisieren, der für eine zuverlässige Antwort erforderlich ist, und nicht nur auf dem Schwellenwert.
Verarbeitungsmodi und Anwendungsabonnements sind unterschiedlich
Fast kostet das Doppelte und Ultrafast das Sechsfache des Standardtarifs; Batch und Flex liegen 50 % unter Standard, abhängig von Verfügbarkeit und Betriebsbedingungen. Dies sind Preismultiplikatoren, keine garantierten Geschwindigkeitsmultiplikatoren. Betrachten Sie Latenz und Terminplanung: Arbeit, die eine sofortige Reaktion erfordert, unterscheidet sich von einem asynchronen Job, der später abgeschlossen werden kann.
Die Modelldokumentation vom Oktober 2026 besagt, dass GPT-6.1 Sol die US- und EU-Datenresidenz unterstützt, einschließlich Fast und Ultrafast. Regionale Verarbeitung kostet einen Aufschlag von 10 %, wo verfügbar. Prüfen Sie die unterstützte Kombination aus Region, Verarbeitungsmodus und Kontoeinstellungen. Übertragen Sie Beschränkungen anderer Modelle zur Datenresidenz nicht auf dieses Modell.
Die Preise für API-Token sind nicht dieselben wie die Preise für ChatGPT- oder Codex-Abonnements. Verfügbare Modelle, Tools und Nutzungsbeschränkungen in einer Anwendung hängen vom Konto und Plan ab, daher sollte die API-Preisgestaltung nicht dazu verwendet werden, auf die Berechtigung eines Abonnements zu schließen.
Quelle: GPT-6.1 Sol Preisgestaltung, Verarbeitungsmodi und Details zur Datenresidenz.
Wie ist es im Vergleich zu GPT-6 Sol, Astra und Luna?
Ähnliche Namen bedeuten nicht identische Fähigkeiten, Einstellungen oder Preise. In der folgenden Tabelle werden Positionierungs- und Standard-API-Raten verglichen; es handelt sich nicht um einen Performance-Benchmark.
| Modell | Allgemeine Positionierung | Input | Cache-Lesezugriffe | Output |
|---|---|---|---|---|
| GPT-6.1 Sol | Kapazität-Kosten-Balance für komplexe Arbeit | $2.00 | $0.10 | $10.00 |
| GPT-6 Sol | Komplexe Codierung und agentische Arbeit | $2.00 | $0.20 | $10.00 |
| GPT-6 Astra | Die anspruchsvollste Arbeit | $10.00 | $1.00 | $50.00 |
| GPT-6 Luna | Fokussierte, hochvolumige Aufgaben | $0.10 | $0.01 | $0.50 |
Die Preise verstehen sich in USD pro 1 Million Token zu Standardpreisen, ohne Long-Input-Multiplikatoren, Tools und andere anwendbare Anpassungen. Ein niedrigerer Token-Preis bedeutet nicht immer niedrigere Kosten für abgeschlossene Aufgaben: Modelle können unterschiedliche Anzahlen von Token verwenden oder unterschiedliche Mengen an Wiederholungen und Korrekturen erfordern.
Der Cache-Input-Preis von GPT-6.1 Sol ist in diesem Vergleich halb so hoch wie der von GPT-6 Sol. Das macht die ganze Rechnung nicht halb so groß. Der Vorteil hängt davon ab, wie viel Input die zwischengespeicherte Rate erhält und wie viel von der Rechnung aus Output und anderen Gebühren stammt.
Quellen: OpenAI Modellvergleich und GPT-6 Sol Dokumentation.
Für einen breiteren Vergleich, der die GPT-5.6-Familie enthält, siehe GPT-6 vs. GPT-5.6: Sechs Modelle im Vergleich nach Einsatzgebiet und API-Kosten (englisch). Verwenden Sie die Auswahlkriterien neben den neuesten offiziellen Spezifikationen und Preisen.
Reasoning-Einstellungen und API-Kompatibilität brauchen Aufmerksamkeit
Die Einstellung Reasoning-Aufwand steuert, wie viel Rechenaufwand das Modell in die Bearbeitung eines Problems investieren soll. GPT-6.1 Sol unterstützt low, medium, high, xhigh und max, mit medium als Standard. Die Werte none und minimal werden nicht unterstützt.
GPT-6 Sol unterstützt none, daher sollte eine bestehende Konfiguration nicht migriert werden, indem nur der Modellname geändert wird. Überprüfen Sie auch die Reasoning-Einstellungen und die Kompatibilität mit Tool-Calling. GPT-6.1 Sol unterstützt Tool-Aufrufe über die Responses-API; die Tool-Nutzung wird über Chat Completions nicht unterstützt.
Quelle: OpenAIs Leitfaden zur aktuellen Modellfamilie.
Beginnen Sie mit der Standardeinstellung für repräsentative Aufgaben und passen Sie dann an, ob die Ergebnisse dies rechtfertigen. Vergleichen Sie die Antwortqualität, die Revisionsanforderungen, die Latenz und die abrechenbare Nutzung mit den gleichen Eingaben. Wenn Sie sowohl das Modell als auch die Reasoning-Einstellung auf einmal ändern, ist es schwieriger, die Ursache eines Unterschieds zu identifizieren.
Was sollten Sie bei der Migration von GPT-6 Sol überprüfen?
Speichern Sie eine funktionierende Anfragekonfiguration und repräsentative erfolgreiche Fälle, bevor Sie das Modell ändern. Dies gibt Ihnen einen Rollback-Punkt. Das Folgende ist ein Überprüfungsprozess und nicht die Behauptung, dass eine Migration für diesen Artikel getestet wurde.
- Modell und Einstellungen anpassen. Bevor Sie
modelaufgpt-6.1-solsetzen, überprüfen Sie, ob der vorhandene Reasoning-Aufwand unterstützt wird. Im offiziellen Migrationshandbuch wird empfohlen, mitlowzu beginnen, wenn eine nicht unterstütztenone- oderminimal-Einstellung migriert wird, und dann repräsentative Aufgaben zu bewerten. - Endpunkt und Tools prüfen. Verwenden Sie die Responses API, wenn Tools benötigt werden. Unterscheiden Sie Anfragen mit und ohne Tools und überprüfen Sie sowohl eine abgeschlossene Antwort als auch die Fortsetzung nach den Werkzeugergebnissen.
- Nicht unterstützte Parameter entfernen. Bei aktiviertem Reasoning, das dieses Modell voraussetzt, überprüfen Sie
temperature,top_pundtop_logprobsmit dem Migrationsleitfaden. Überprüfen Sie auchlogprobsin Chat Completions undmessage.output_text.logprobsim Parameterincludeder Responses API. - Vergleichen Sie Fertigstellung und Nutzung. Erfassen Sie bei gleichem Ausgangsmaterial die Genauigkeit, das Ausgabeformat, das Tool-Verhalten, den Abschlussstatus und den Verbrauch an Eingabe-, Cache- und Ausgabe-Token. Wenn das neue Setup fehlschlägt, stellen Sie die gespeicherte Konfiguration wieder her und isolieren Sie die Änderung, bevor Sie es erneut versuchen.
Geben Sie für Artikelarbeiten die gleichen offiziellen Dokumente und Fragen an und vergleichen Sie dann Ansprüche, Zahlen und Bedingungen mit einem konsistenten fact-checking-Prozess (englisch). Ändern Sie jeweils nur eine Variable. So lässt sich besser erkennen, ob ein Unterschied auf das Modell, den Prompt, den Reasoning-Aufwand oder die Tools zurückgeht.
Wer sollte GPT-6.1 Sol in Betracht ziehen?
Die folgenden Vorschläge sind Ausgangspunkte für die Bewertung, keine festen Regeln oder Erkenntnisse aus unseren eigenen Tests.
| Situation | Kandidat und Begründung | Was zu überprüfen ist |
|---|---|---|
| Komplexe Artikel, Dokumentanalyse oder Codierung, bei denen es auf die Kosten ankommt | Bewerten Sie GPT-6.1 Sol für ein Gleichgewicht von Fähigkeit und Preis. | Qualität, Revisionsbedarf und Gesamtkosten einer abgeschlossenen Aufgabe. |
| Einfache Einstufung oder Extraktion bei hohem Volumen | Bewerten Sie Luna, bevor Sie für ein leistungsfähigeres Modell bezahlen. | Ausnahmen und schwierige Eingaben, nicht nur einfache Beispiele. |
| Widersprüchliche Beweise oder kostspielige Ausfälle | Vergleichen Sie Astra mit GPT-6.1 Sol über die eigentliche Arbeit. | Quellenbezug, Schwere möglicher Fehler und jede notwendige professionelle Überprüfung. |
| Ein bestehender GPT-6 Sol Workflow funktioniert bereits zuverlässig | GPT-6.1 Sol vor der Migration auswerten. | Kompatibilität, Ausgabeformate und Regressionen bei zuvor erfolgreichen Aufgaben. |
Quelle: OpenAIs Leitfaden zur Modellauswahl.
Geben Sie den Kandidaten für einen Blogging-Workflow die gleiche Gliederung und das gleiche Quellmaterial. Überprüfen Sie, ob jeder Entwurf die versprochene Frage beantwortet, sachliche Fehler oder nicht unterstützte Behauptungen enthält und einer umfangreichen Bearbeitung bedarf. Länge und ein selbstbewusster Ton sind ein schlechter Ersatz für diese Überprüfung.
Einschränkungen und eine praktische Evaluations-Checkliste
GPT-6.1 Sol ersetzt keine Verifizierung. Überprüfen Sie für aktuelle Informationen die Originalquellen und bestätigen Sie Zahlen und Links. Wenn ein Fehler ernsthaften Schaden verursachen könnte, wie z. B. rechtliche, finanzielle oder gesundheitliche Beratung, bleibt eine angemessene Expertenüberprüfung wichtig.
Tool-Berechtigungen verdienen auch separate Aufmerksamkeit. Die Veröffentlichung von Inhalten, das Löschen von Dateien, Zahlungen und das Senden von Nachrichten können Folgen haben, die schwer rückgängig zu machen sind. Verwenden Sie Genehmigungsanforderungen, Protokolle und klare Stoppbedingungen. Ein leistungsfähigeres Modell rechtfertigt nicht automatisch breitere Berechtigungen.
- Repräsentative Beispiele vorbereiten. Fügen Sie sowohl einfache als auch schwierige Fälle hinzu und entfernen Sie sensible Informationen, die nicht erforderlich sind.
- Akzeptanzkriterien definieren. Genauigkeit, Ausgabeformat, Nachweisanforderungen und akzeptable Bearbeitungszeit festlegen, bevor die Ergebnisse verglichen werden.
- Behalten Sie den Vergleich kontrolliert. Verwenden Sie die gleichen Eingaben und Werkzeuge und zeichnen Sie Fehler und Wiederholungen auf, anstatt nur die endgültige Antwort zu beurteilen.
- Vergleichen Sie die Kosten für akzeptable Ergebnisse. Unter den Kandidaten, die Ihre Kriterien erfüllen, sollten Sie die gesamte API-Nutzung und die menschliche Korrekturzeit berücksichtigen.
- Nach Regressionen suchen. Vorherige erfolgreiche Fälle nach Änderung des Modells oder seiner Einstellungen wiederholen.
GPT-6.1 Sol ist es wert, bewertet zu werden, wenn komplexe Arbeit starke Fähigkeiten ohne den Standard-Token-Preis von Astra erfordert. Einfachere Aufgaben können zu einem leichteren Modell passen, während besonders schwierige Arbeit einen direkten Vergleich erfordert. Die nützliche Entscheidung ist diejenige, die durch Ihre eigenen Ergebnisse für Qualität, Zeit und Gesamtkosten unterstützt wird.