Come rendere il blog accessibile ai crawler della ricerca di ChatGPT
Per rendere il blog accessibile alla ricerca di ChatGPT, controllate anzitutto che OAI-SearchBot, il crawler di ricerca di OpenAI, possa raggiungerlo. Il suo compito è diverso da quello di GPTBot, che raccoglie contenuti potenzialmente utilizzabili per addestrare i modelli: le due autorizzazioni possono essere gestite separatamente. Consentire l'accesso a un crawler non garantisce che una determinata risposta mostri o citi il sito.
Distinguere i crawler di ricerca e di addestramento
Un crawler è un programma che recupera automaticamente pagine web. OpenAI usa diversi agenti utente, o user agent, per scopi diversi. Si tratta delle informazioni con cui il programma che invia una richiesta si identifica; il gestore del sito può esprimere regole di accesso per quei nomi.
| Nome | Scopo principale | Aspetto da distinguere |
|---|---|---|
| OAI-SearchBot | Raccolta automatica per i risultati della ricerca di ChatGPT | Regole di accesso per la ricerca |
| GPTBot | Raccolta di contenuti che potrebbero essere usati per addestrare modelli di base | Autorizzazione alla raccolta per l'addestramento |
| ChatGPT-User | Visite avviate da una richiesta dell'utente | Comportamento diverso da quello di un crawler di ricerca automatico |
La documentazione ufficiale sui crawler di OpenAI spiega che le impostazioni per ricerca e addestramento sono indipendenti. Precisa inoltre che le regole di robots.txt potrebbero non applicarsi alle visite avviate dall'utente. Bloccare soltanto GPTBot, quindi, non equivale a controllare ogni tipo di accesso collegato a ChatGPT.
La documentazione distingue anche le risposte di ricerca dai collegamenti di navigazione. I siti che escludono OAI-SearchBot non vengono mostrati nelle risposte di ricerca, ma possono ancora comparire come link di navigazione. La presenza di un link non dimostra che il corpo della pagina sia stato recuperato correttamente. Nemmeno le visite di ChatGPT-User determinano l'idoneità del sito per la ricerca.
Registrare le impostazioni attuali di accesso pubblico
Prima di intervenire, definite la vostra politica: il sito deve essere reperibile attraverso la ricerca? La raccolta per l'addestramento è consentita? Quali materiali devono rimanere privati? Salvate robots.txt e le configurazioni di sicurezza pertinenti, per poterli ripristinare se il risultato non è quello desiderato.
- Aprite l'articolo da rendere reperibile senza aver effettuato l'accesso e verificate che il contenuto sia disponibile.
- Aprite
/robots.txtsullo schema e sull'host pubblici effettivi. L'ambito dihttps://example.com/robots.txtè diverso da quello dihttps://www.example.com/robots.txt. - Controllate i gruppi specifici per OAI-SearchBot e GPTBot e il gruppo predefinito
User-agent: *, utilizzato quando non esiste un gruppo corrispondente al crawler. - Cercate eventuali blocchi aggiuntivi nell'hosting, nei plugin di sicurezza o nella rete di distribuzione dei contenuti.
Un sito WordPress può fornire robots.txt attraverso un file fisico sul server, un plugin o una risposta generata dinamicamente. Per esempio, la funzione di base do_robots() di WordPress produce una risposta che altri componenti possono filtrare. Verificate che le modifiche nel pannello di amministrazione raggiungano davvero la risposta pubblica. Identificate il componente che la gestisce, senza presumere che sia installato un determinato plugin.
Leggere un esempio che consente la ricerca e vieta l'addestramento
L'esempio seguente consente l'accesso di ricerca ai contenuti pubblici e vieta la raccolta da parte di GPTBot. Non è un file completo da sostituire indiscriminatamente a quello di ogni sito. Conservate le dichiarazioni della sitemap e le restrizioni ancora necessarie, integrando le regole in base alla vostra politica.
User-agent: OAI-SearchBot
Allow: /
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-agent: GPTBot
Disallow: /
Il gruppo OAI-SearchBot include anche la restrizione per /wp-admin/ e l'eccezione per admin-ajax.php comuni in WordPress. Verificate che siano adatte al vostro sito. Una regola Disallow più specifica può applicarsi anche in presenza di Allow: /. Nel gruppo GPTBot, invece, Disallow: / dichiara che la raccolta non è consentita su tutti i percorsi. Aggiungete separatamente altre esclusioni necessarie, per esempio per le aree riservate agli iscritti.
Non date per scontato che un gruppo specifico erediti le restrizioni di User-agent: *. Le regole di selezione dei gruppi nello standard robots.txt usano il gruppo predefinito se non esiste un gruppo corrispondente all'agente. Se il gruppo predefinito escludeva alcuni percorsi, controllate che le esclusioni necessarie siano presenti anche nel gruppo OAI-SearchBot. I materiali privati devono comunque essere protetti con autenticazione e autorizzazione.
L'esempio si interpreta nel modo seguente. Sono interpretazioni delle regole, non osservazioni di richieste provenienti dai server di OpenAI:
- OAI-SearchBot su un normale articolo pubblico: accesso consentito, salvo una restrizione più specifica.
- OAI-SearchBot sui percorsi sotto
/wp-admin/: accesso vietato dalla restrizione. - OAI-SearchBot su
/wp-admin/admin-ajax.php: si applica l'eccezione più specifica. - GPTBot sui percorsi degli articoli: la politica vieta la raccolta per l'addestramento.
RFC 9309 combina le regole quando più gruppi corrispondono allo stesso agente, poi applica la regola corrispondente al percorso più specifico. Non interpretate il file come se “l'ultima riga vincesse sempre”.
Prima di salvare, cercate eventuali altri gruppi per lo stesso agente e risolvete duplicazioni o contraddizioni. In seguito controllate le cache e riaprite /robots.txt pubblico, confrontando le regole effettivamente fornite con quelle desiderate. Se il risultato differisce, ripristinate file e impostazioni originali e indagate su quale componente gestisce la risposta.
OpenAI indica che i suoi sistemi possono impiegare circa 24 ore per adeguarsi alle modifiche di robots.txt. Questo intervallo riguarda l'aggiornamento delle regole di accesso: non promette che il sito venga scoperto o citato entro 24 ore.
L'accesso può fallire anche se robots.txt lo consente
Il permesso espresso in robots.txt e l'accettazione della richiesta da parte del server sono verifiche distinte. Firewall, protezioni contro i bot, obbligo di accesso o problemi di connessione possono impedire il recupero della pagina. Se sono disponibili registri dei blocchi, controllate URL interessato, orario e nome della regola applicata.
Una rete di distribuzione dei contenuti, o content delivery network (CDN), fornisce risorse da punti vicini ai visitatori. Può anche applicare regole contro i bot prima che le richieste raggiungano l'hosting. Una risposta 403, una pagina di accesso o una richiesta di verifica nei suoi registri richiedono quindi un'indagine che vada oltre robots.txt.
Evitate di cominciare disattivando tutte le protezioni contro i bot. Individuate la regola responsabile e modificate soltanto l'ambito necessario. Una richiesta di prova con un nome user agent cambiato non dimostra che provenga da OpenAI. Confrontate anche gli intervalli IP ufficiali collegati nella documentazione di OAI-SearchBot con i metodi di verifica delle richieste del vostro fornitore. Usate l'elenco ufficiale aggiornato, senza considerare permanenti indirizzi copiati da un esempio.
Il fatto che una pagina si apra nel vostro browser non garantisce che il crawler riceva la stessa risposta. Al contrario, una singola richiesta automatica bloccata non dimostra che siano bloccati tutti i lettori o tutti i crawler. Registrate quale richiesta avete verificato e in quali condizioni.
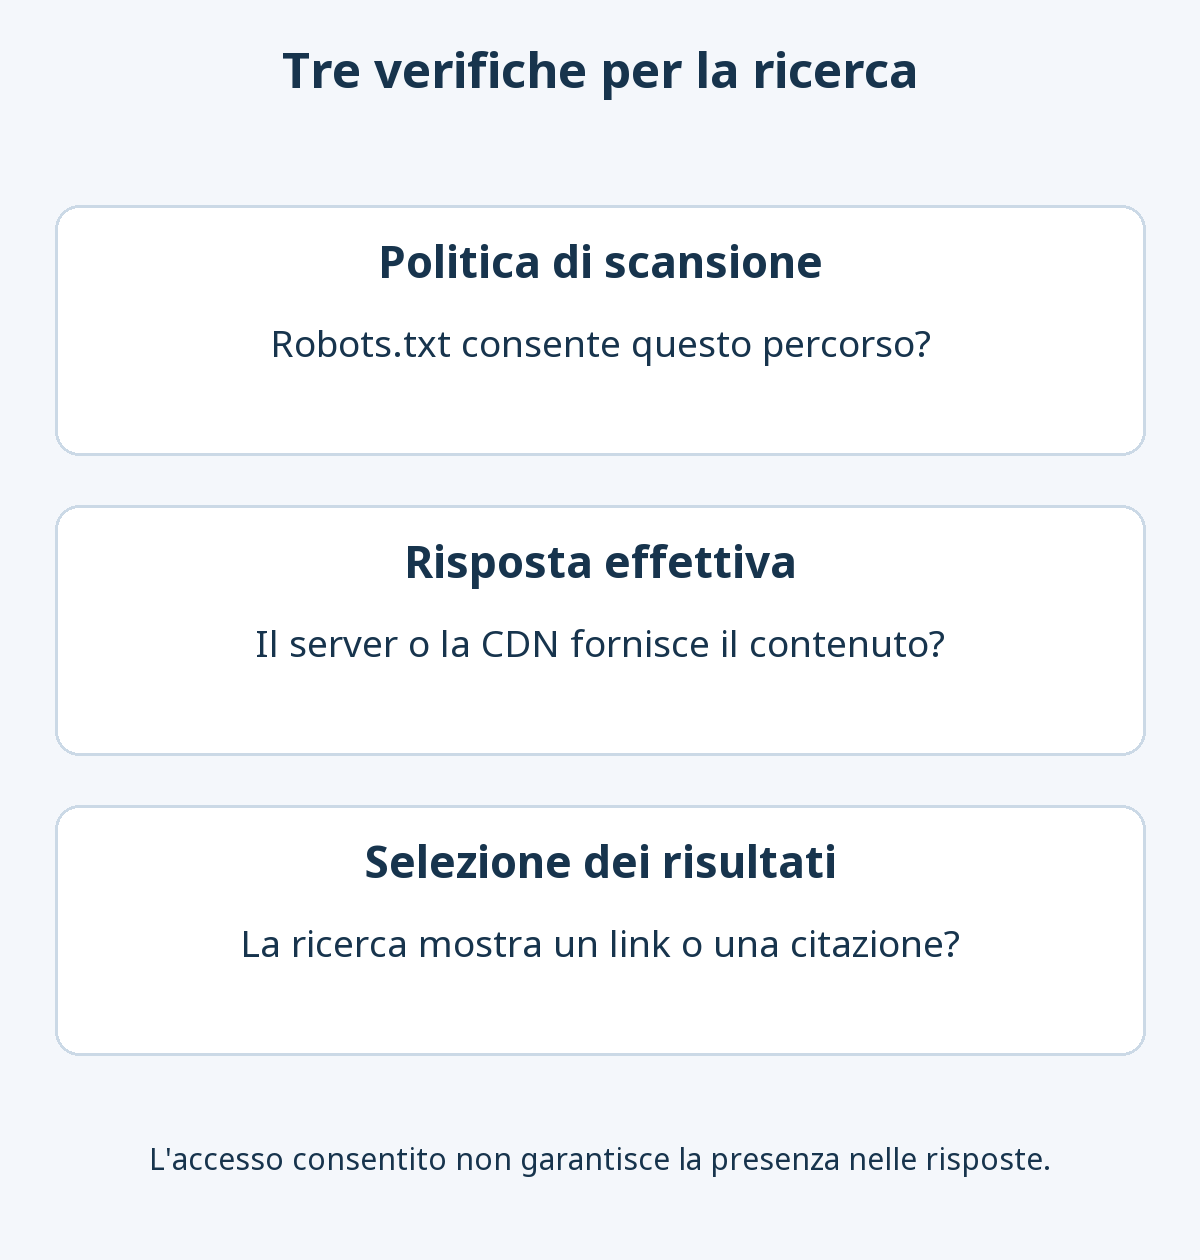
Politica di scansione, risposta effettivamente fornita e selezione nei risultati sono verifiche diverse. Il diagramma le separa per rendere evidente che cosa è stato accertato e che cosa rimane incerto.
Separare la configurazione dell'accesso dalla visibilità
Dopo aver configurato l'accesso, esaminate contenuto e collegamenti della pagina. La risposta principale è pubblica? I lettori possono raggiungerla da articoli o categorie pertinenti? Il titolo corrisponde al testo? Consentire la ricerca non crea un interruttore che faccia comparire il link in ogni risposta.
Registrate separatamente “robots.txt risponde”, “sono fornite le regole previste”, “il contenuto pubblico è accessibile” e “il sito è stato trovato nella ricerca”. L'ultimo risultato può cambiare con la formulazione e il momento della ricerca: una sola prova non permette di stabilire in modo affidabile se la configurazione abbia funzionato.
La documentazione dei crawler descrive il ruolo dell'accesso; per accertare che il contenuto sia stato davvero recuperato servono registri affidabili del server o della CDN. Per il contenuto, potete consultare i ruoli di SEO, AEO e GEO nell'organizzazione di contenuti utili. Tenete distinti i problemi di accesso dalla capacità dell'articolo di rispondere alla domanda e offrire un riferimento valido.
Per l'indicizzazione su Google, consultate come controllare lo stato di indicizzazione di un articolo in Search Console. Lo stato dell'indice di Google e la visibilità nella ricerca di ChatGPT non sono intercambiabili.
Non usare robots.txt come barriera di sicurezza
Robots.txt è una dichiarazione pubblica della politica di scansione, non un meccanismo di autenticazione per materiali privati. Anche l'introduzione di Google a robots.txt spiega che non tutti i crawler ne rispettano le regole. Proteggete contenuti riservati e informazioni amministrative mediante autenticazione e permessi.
Conservate insieme file modificato, regole di sicurezza e risposta pubblica effettiva, così da sapere che cosa ripristinare se emerge un problema. Definire prima l'ambito della ricerca pubblica e quello dei materiali privati riduce il rischio di ampliare inutilmente l'accesso durante la verifica della visibilità.